


Perché i tuoi numeri potrebbero essere sbagliati: punti chiave del CS50 per i professionisti dei dati
Questo articolo traduce i concetti fondamentali dell'informatica per analisti e scienziati dei dati, mostrando come una comprensione più approfondita dell'informatica possa prevenire bug comuni, risolvere problemi di prestazioni e migliorare l'affidabilità del lavoro.
Introduzione: gli insetti nascosti in bella vista
Vi sarà capitato: una pipeline di dati si blocca inspiegabilmente, uno script è molto più lento del previsto o una query SQL restituisce un numero che sembra semplicemente sbagliato. Potreste dare la colpa agli strumenti di alto livello o alla complessità dei dati stessi. Il vero colpevole, tuttavia, spesso risiede nei principi fondamentali dell'informatica su cui si basano i vostri script Python e le vostre query SQL. Trascurando i dettagli "di basso livello" del funzionamento effettivo dei computer, introducete errori sottili e difficili da diagnosticare nelle vostre analisi.
Questo post è una sintesi basata sul corso CS50x 2025 (Harvard) disponibile su YouTube. Questo post sintetizza diversi spunti di grande utilità tratti dalla prima lezione sulla programmazione in C, direttamente applicabili al lavoro quotidiano di qualsiasi professionista dei dati, aiutandovi a costruire sistemi di dati più robusti, performanti e corretti.
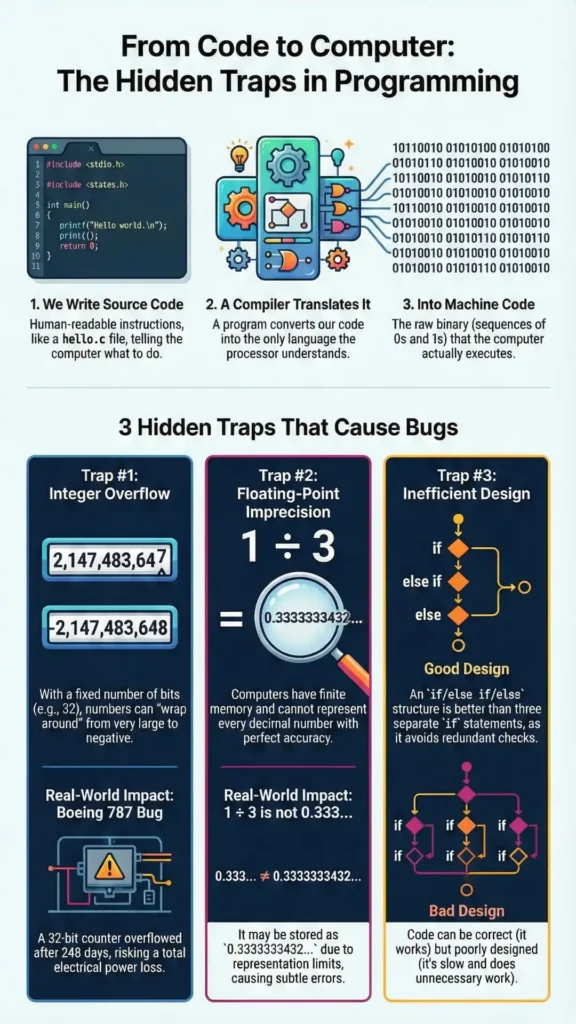
1. Codice sorgente vs. codice macchina: il "perché" dietro le prestazioni
In sostanza, il processore di un computer comprende un solo linguaggio: il codice macchina, una sequenza di zeri e uno. Il codice che scrivi, che sia in Python, SQL o C, si chiama codice sorgente: un insieme di istruzioni leggibili dall'uomo. Per colmare questa lacuna, un programma speciale chiamato compilatore traduce il codice sorgente in codice macchina, che il computer può effettivamente eseguire.
Nella lezione, il make hello command is used to compile a C source code file (hello.c) into an executable program (hello) composed of machine code. This compilation step is the key to understanding performance differences between programming languages and tools.
Collegamento della scienza dei dati: Nella mia esperienza, questa è una delle fonti di colli di bottiglia prestazionali più trascurate nei team di data science. Linguaggi interpretati come Python spesso nascondono questa fase di compilazione, ma molte librerie di data science ad alte prestazioni (come NumPy o Pandas) sono scritte in linguaggi compilati come C per un motivo. Pensate a... for loop in pure Python to calculate a moving average over millions of rows—it could take minutes. The equivalent NumPy function, which calls pre-compiled C code, executes in milliseconds. That’s the performance gap we’re talking about. This is why you must understand this distinction to choose the right tools and avoid crippling bottlenecks in your data pipelines.
"I computer ovviamente non capiscono il codice sorgente, capiscono solo zeri e uno, questo è il cosiddetto sistema binario, quindi in qualche modo dobbiamo trasformare ciò che sembra già criptico in qualcosa che a prima vista sembra ancora più criptico, gli zeri e gli uno che i computer capiscono." – Harvard CS50x 2025 (YouTube) — Lezione: C
2. La riga di comando non è arcaica, è potente
Probabilmente interagisci con i computer tramite un'interfaccia utente grafica (GUI), il mondo di icone, finestre e clic del mouse. L'interfaccia a riga di comando (CLI), o terminale, può sembrare un "passo indietro" verso un ambiente puramente testuale. Tuttavia, la CLI offre un livello di potenza, efficienza e automazione impossibile da raggiungere con una GUI, ed è per questo che rimane l'ambiente preferito da molti sviluppatori.
La lezione introduce alcuni comandi essenziali che costituiscono la base della navigazione e della manipolazione del file system: ls (list files), cd (change directory), mv (move or rename a file), and rm (remove a file).
Collegamento della scienza dei dati: la padronanza della riga di comando (CLI) è imprescindibile per chi lavora seriamente con i dati. È il metodo principale con cui interagirai con i server remoti in cui risiedono i tuoi dati e modelli. È essenziale per automatizzare le pipeline di dati con strumenti di pianificazione (come i cron job), gestire le risorse cloud su AWS o GCP e utilizzare sistemi di controllo di versione come Git per garantire la riproducibilità del tuo lavoro. Un'interfaccia grafica (GUI) va bene per l'esplorazione locale, ma l'automazione e la riproducibilità risiedono nella riga di comando.
3. Un quadro per la qualità: correttezza, progettazione e stile
Valutare il codice non è una semplice questione di "funziona" o "non funziona". La lezione offre un quadro di riferimento semplice ma efficace, articolato in tre parti, per valutare la qualità di qualsiasi programma, applicabile tanto a uno script analisi dei dati quanto a un'applicazione in linguaggio C.
- Correttezza: Il codice produce il risultato previsto? Se gli si chiede di calcolare una media, restituisce il numero corretto? Questa è la base di partenza per qualsiasi codice funzionale.
- Design: Quanto è ben scritto il codice? È efficiente e logico? La lezione fornisce un esempio di progettazione scadente: il controllo esplicito.
if x == yafter you have already checked forx < yex > y. Logically, equality is the only remaining possibility, so the final check is redundant. - Tipologia: Il codice è leggibile ed esteticamente gradevole per gli altri utenti? Questo include aspetti come l'indentazione coerente, nomi di variabili chiari e spaziatura logica, che non hanno alcun impatto sul computer, ma hanno un impatto enorme sulla manutenibilità.
Collegamento della scienza dei dati: Questo framework è qualcosa che utilizzo in ogni revisione del codice per una pipeline di dati. Una pipeline può essere correggere (produce il report giusto) ma male progettatoUna pipeline mal progettata potrebbe rileggere un file CSV da 10 GB dal disco all'interno di un ciclo per tre diverse fasi di elaborazione, invece di leggerlo in memoria una sola volta. Entrambe le soluzioni sono "corrette", ma una è di ordini di grandezza più lenta e costosa. Allo stesso modo, una pipeline mal progettata... stile in un contesto di dati non è solo un rientro disordinato; è una query SQL di 500 righe senza commenti, CTE denominati temp1, temp2, and crucial business logic buried in a subquery six levels deep. It’s unmaintainable.
4. Non ripeterti: astrazione tramite funzioni e librerie
Un principio fondamentale della programmazione efficace è l'astrazione: risolvere un problema una sola volta e poi impacchettare la soluzione per riutilizzarla. Questo evita ripetizioni e rende il codice più facile da leggere e manutenere. La lezione evidenzia due forme principali di astrazione.
Il primo è usare biblioteche. Includendo una linea come #include <stdio.h> o #include <cs50.h> grants a programmer access to a library of pre-written, pre-tested code. This means they can use powerful functions like printf (to print to the screen) without having to write the complex underlying code from scratch themselves.
Il secondo è creare funzioni personalizzateIn un esempio semplice ma illustrativo, la lezione crea un meow function to contain the logic of printing “meow” to the screen. By calling meow() three times instead of printf("meow") three times, the main part of the program becomes cleaner and more clearly expresses its intent.
Collegamento della scienza dei dati: Questo principio è il fondamento dell'intero ecosistema moderno della data science. Non scriviamo codice per creare data frame o eseguire regressioni da zero; utilizziamo librerie come pandas, NumPy e scikit-learn. Su scala più piccola, è necessario applicare lo stesso ragionamento al proprio lavoro. Se vi trovate ripetutamente a utilizzare espressioni regolari per estrarre un ID prodotto da un campo di testo disordinato, incapsulate tale logica in un def extract_product_id(text): function. Your main analysis script becomes cleaner, and that function can now be reused across multiple projects.
5. Il bug da un miliardo di dollari: l'overflow degli interi
La lezione presenta una dimostrazione efficace: un programma parte dal numero 1 e chiede ripetutamente all'utente se desidera "raddoppiarlo e darlo alla persona successiva". Il numero cresce esponenzialmente fino a raggiungere miliardi, poi improvvisamente diventa un grande numero negativo e infine scende a zero. Non si tratta di un errore logico nel codice, bensì di una limitazione fondamentale del computer.
Questo fenomeno è chiamato overflow degli interi. I computer memorizzano gli interi utilizzando un numero fisso di bit (ad esempio, 32 bit). Un intero a 32 bit può rappresentare solo numeri fino a circa 2 miliardi. Quando si tenta di aggiungere 1 a questo valore massimo, non c'è più spazio. I bit "si avvolgono" e l'enorme numero positivo si trasforma in un enorme numero negativo, causando un errore catastrofico e silenzioso.
Non si tratta solo di un problema teorico. La lezione fa riferimento a un problema reale del Boeing 787, in cui un contatore software di monitoraggio del tempo andava in overflow dopo 248 giorni di funzionamento continuo, causando potenzialmente la perdita di tutta l'energia elettrica dell'aereo.
Collegamento della scienza dei dati: Un errore classico e costoso che vedo commettere agli analisti junior è ignorare il rischio di overflow di interi. Ecco perché è necessario essere vigili nella scelta dei tipi di dati appropriati. Gli amministratori di database sono attenti a scegliere BIGINT instead of INT for primary keys (like user IDs) that could one day exceed 2 billion. Imagine summing a transaction column that overflows; your final financial report would be dramatically, silently incorrect. Always be aware of the limits of the data types you’re using.
6. Le bugie che racconta il tuo computer: l'imprecisione in virgola mobile
Proprio come gli interi hanno un numero finito di bit, così fanno i numeri in virgola mobile (i numeri con punti decimali, memorizzati come float o double). This leads to another subtle but critical issue: imprecisione in virgola mobile.
La lezione fornisce un esempio chiaro: quando un programma divide 1 per 3, il risultato non è una serie infinita di 0.333333.... Instead, it might be something like 0.3333333432... after a certain number of decimal places. The root cause is the same: with a finite number of bits, a computer cannot represent all possible real numbers with perfect accuracy. It stores a very close approximation, but the tiny difference can have major consequences.
Collegamento della scienza dei dati: Ignorare questo porterà a bug silenziosi e fastidiosi nella tua analisi. Un semplice controllo come if column_a == 0.3 might unexpectedly fail because the value is actually stored as 0.29999999999999998. These tiny errors can accumulate during complex calculations, potentially affecting statistical tests, model coefficients, or any task that relies on high numerical accuracy. The best practice is a hard rule: mai verificare l'esatta uguaglianza con i numeri in virgola mobile; verificare invece se rientrano in una piccola tolleranza reciproca.
Cosa presentare domanda oggi: una checklist in 5 punti
- Rivedere i tipi di dati in una tabella di database chiave. È un
INTsufficient for a primary key that could grow beyond 2 billion? Consider upgrading toBIGINT. - Scrivi una funzione personalizzata nel tuo prossimo script di analisi per gestire un'attività ripetitiva di pulizia o trasformazione dei dati anziché copiare e incollare il codice.
- Utilizzare un formattatore di codice (come Black per Python o un formattatore SQL online) per migliorare automaticamente lo stile e la leggibilità del tuo prossimo script.
- Apri un terminale e trascorri cinque minuti navigando nella struttura dei file del tuo progetto usando solo
ls(list) andcd(change directory). - Nella tua prossima revisione del codice, fai una domanda sul design, non solo correttezza. Ad esempio, "Questa query funziona, ma questa logica potrebbe essere semplificata per renderla più efficiente?"
Pensieri di chiusura
Sebbene concetti come l'allocazione della memoria e il codice macchina possano sembrare lontani dalla costruzione di un modello di classificazione, rappresentano il fondamento su cui si basano tutti i sistemi di dati affidabili e robusti. Ignorarli significa ignorare un'intera classe di potenziali bug e problemi di prestazioni. Il corso CS50 continua a basarsi su queste idee di basso livello, muovendosi verso linguaggi di livello superiore e problemi più complessi. Riconoscere questi fondamenti è il primo passo verso la scrittura di codice di cui ci si può veramente fidare.
Quale di questi dettagli informatici "invisibili" ha avuto più probabilmente un impatto su una delle tue analisi passate senza che tu te ne rendessi conto?





