


Strutture dati: guida per gli scienziati dei dati
Questo articolo aiuta i professionisti dei dati a comprendere le strutture dati fondamentali per scrivere codice più veloce e con un uso più efficiente della memoria.
Un collo di bottiglia comune negli script di elaborazione dati, dai lenti loop di feature engineering alle ricerche inefficienti, può spesso essere ricondotto a una discrepanza tra l'attività e la struttura dati sottostante utilizzata. La causa principale di questi problemi di prestazioni spesso non risiede nella logica del codice, ma nel modo in cui i dati sono organizzati in memoria. Comprendere queste strutture, e i loro compromessi, è un'abilità fondamentale per scrivere pipeline di analisi efficienti e scalabili. Questo post riassumerà le lezioni chiave sulle strutture dati dal rinomato corso CS50x di Harvard, collegando questi fondamenti dell'informatica direttamente al mondo pratico dell'analisi dei dati e della data science. Questo post è una sintesi basata su CS50x 2025 (Harvard) su YouTube.
1. Array e il loro costo nascosto di ridimensionamento
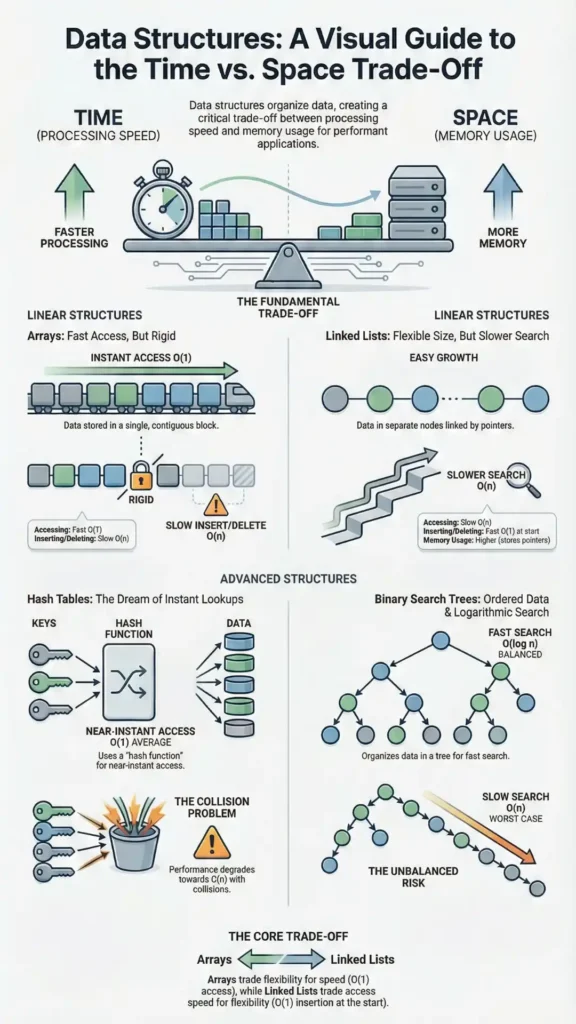
Un array è una semplice struttura dati in cui elementi dello stesso tipo sono memorizzati in modo consecutivo ("contiguo") in memoria. Questa disposizione contigua rende estremamente rapido l'accesso a qualsiasi elemento tramite il suo indice. Tuttavia, gli array presentano una limitazione critica: è necessario deciderne in anticipo la dimensione.
Cosa succede quando è necessario "far crescere" un array già pieno? Non è possibile aggiungere semplicemente un nuovo elemento alla fine se quella posizione di memoria è già occupata. L'unica soluzione è allocare un blocco di memoria completamente nuovo e più grande, copiare manualmente ogni singolo elemento dal vecchio array a quello nuovo e quindi liberare la memoria utilizzata dall'array originale. Questo processo di copia è un'operazione che richiede molto tempo e "tempo lineare": più grande è l'array, più tempo richiede.
Connessione alla scienza dei dati
Molti strumenti di gestione dei dati comuni, come le liste Python, si comportano come "array dinamici". Sebbene sembrino espandersi automaticamente, in realtà eseguono questo costoso ridimensionamento internamente. Per velocizzare le operazioni di aggiunta, le liste Python utilizzano la sovraallocazione, ovvero riservano spazio extra, il che si traduce in un tempo costante ammortizzato (O(1)) per le aggiunte. Tuttavia, l'inserimento di un elemento all'inizio di una lista di grandi dimensioni è lento non solo a causa del potenziale ridimensionamento, ma anche perché richiede lo spostamento di ogni elemento successivo di una posizione a destra, con un costo diretto di O(n).
2. Liste concatenate: scambio di memoria contigua per flessibilità
Una lista concatenata offre una soluzione al problema del ridimensionamento rigido degli array. Invece di memorizzare gli elementi in modo contiguo, una lista concatenata è una serie di "nodi" che possono essere posizionati ovunque in memoria. Ogni nodo contiene due elementi: un dato e un "puntatore" (un indirizzo) che si collega alla posizione del nodo successivo. Questo consente di "cucire insieme" le posizioni di memoria disponibili secondo necessità.
Questa struttura introduce un compromesso primario:
- upside: L'elenco può crescere e ridursi dinamicamente senza dover spostare tutti gli elementi esistenti. Questo consente un utilizzo più efficiente della memoria frammentata.
- Svantaggio: Utilizza più memoria in generale, perché ogni singolo elemento richiede un puntatore extra per memorizzare l'indirizzo del successivo.
- Svantaggio critico: Si perde la possibilità di eseguire una ricerca binaria veloce. Poiché gli elementi non sono memorizzati in modo contiguo, non è possibile passare immediatamente al centro della lista; è necessario attraversarla un nodo alla volta, partendo dall'inizio.
Connessione alla scienza dei dati
Si consideri un registro eventi in tempo reale in cui gli eventi potrebbero dover essere inseriti o rimossi dal centro di una sequenza in base agli aggiornamenti. Un Python standard list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from entrambi estremità.
3. La verità controintuitiva: la lista più veloce è quella costruita al contrario
Quando si lavora con una lista concatenata, il modo in cui si aggiungono nuovi elementi ha un impatto notevole sulle prestazioni. Per aggiungere un nuovo nodo all'inizio della lista (prepending), è sufficiente creare il nuovo nodo e aggiornare un paio di puntatori all'inizio della lista. Questa operazione è indipendente dalla dimensione totale della lista.
Questo rende l'aggiunta di un nodo all'inizio un'operazione tempo costante (O(1)) , incredibilmente veloce. Al contrario, per aggiungere un nuovo nodo alla fine della lista (aggiunta), è necessario prima attraversare l'intera lista dall'inizio per trovare il nodo finale. Questo rende l'aggiunta un'operazione a linear time (O(n)) , che diventa progressivamente più lenta man mano che la lista cresce.
Il risultato sorprendente è che il modo più efficiente per costruire una lista concatenata da zero è aggiungere ogni nuovo elemento all'inizio. Questo significa che se si inseriscono i numeri 1, poi 2, poi 3, la lista finale in memoria sarà 3 -> 2 -> 1.
Connessione alla scienza dei dati
Questo è un classico esempio di come una scelta apparentemente semplice – aggiungere dati al front-end anziché al back-end – possa avere enormi implicazioni sulle prestazioni (O(1) vs. O(n)). Ciò evidenzia l'importanza di comprendere la complessità temporale delle operazioni che utilizziamo quotidianamente negli script di data cleaning e feature engineering. Un ciclo lento potrebbe nascondere un'operazione lineare che potrebbe essere ottimizzata.
4. Alberi di ricerca binari: ricerche veloci che possono degenerare
Un albero binario di ricerca (BST) tenta di combinare il meglio di entrambi i mondi: la capacità di ricerca rapida di un array ordinato e il ridimensionamento dinamico di una lista concatenata. È un albero di nodi in cui ogni nodo ha fino a due figli. La struttura è governata dalla "proprietà di ricerca binaria": per ogni nodo, tutti i valori nel suo sottoalbero sinistro sono più piccoli e tutti i valori nel suo sottoalbero destro sono più grandi.
Questa proprietà consente una ricerca binaria semplicemente seguendo i puntatori a sinistra o a destra lungo l'albero, ottenendo in media una prestazione di ricerca efficiente con complessità logaritmica (O(log n)) . Tuttavia, l'albero binario di ricerca presenta un difetto critico. Nel "caso perverso" in cui si inseriscono dati già ordinati (ad esempio, inserendo 1, poi 2, poi 3, poi 4), l'albero diventa completamente sbilanciato. Ogni nuovo nodo viene semplicemente aggiunto a destra del precedente.
In questo scenario peggiore, l'albero di ricerca binario "si trasforma in una lista concatenata". Le sue prestazioni di ricerca si degradano da un tempo logaritmico a linear time (O(n)).
Connessione alla scienza dei dati
Il BST sbilanciato è una potente metafora per la differenza tra prestazioni nel caso medio e nel caso peggiore. Nella scienza dei dati, la distribuzione e l'ordine dei dati di input possono influire notevolmente sull'efficienza di un algoritmo. Ecco perché gli indici dei database, spesso basati su strutture ad albero, richiedono complessi algoritmi di "bilanciamento" per riorganizzarsi continuamente e impedire che questo scenario peggiore si verifichi.
5. Tabelle hash: il percorso pratico per il tempo costante
La tabella hash è la struttura dati di riferimento per l'implementazione di dizionari, che memorizzano coppie chiave-valore. Combina magistralmente array e liste concatenate per ottenere ricerche quasi istantanee. I suoi componenti principali sono:
- An schieramento di "secchi".
- A funzione hash che prende una chiave (ad esempio, il nome di una persona) e la converte in modo deterministico in un indice per l'array.
- Elenchi collegati all'interno di ogni bucket per gestire le "collisioni", ovvero i casi in cui due chiavi diverse generano lo stesso indice di array.
L'analogia utilizzata durante la lezione con gli scaffali di Sweetgreen per il ritiro degli ordini illustra perfettamente questo concetto. Il tuo nome sull'ordine è la chiave. L'impiegato che guarda la prima lettera del tuo nome per scegliere uno scaffale (AE, FJ, ecc.) è la funzione hash. Lo scaffale stesso è il contenitore (un indice nell'array). Le poche insalate su quello scaffale che devi esaminare rappresentano la lista concatenata per la gestione delle collisioni. Mentre il caso peggiore teorico è linear time (O(n)) se tutte le chiavi collidono in un'unica lunga lista concatenata, le prestazioni pratiche, nel caso medio, sono notevolmente vicine al tempo costante (O(1)).
"Sì, tecnicamente le tabelle hash sono in N diviso K che in realtà è semplicemente Big O di n, ma in pratica se sei intelligente e se sei abile con la funzione hash che usi... la probabilità di collisioni sarà probabilmente così bassa che anche se occasionalmente la cosa si trasforma in tempo lineare, la maggior parte delle volte sarà effettivamente tempo costante, ovvero Big O di uno." — Harvard CS50x 2025 (YouTube) — Lezione: Strutture dati
Connessione alla scienza dei dati
Le tabelle hash sono il motore dietro i dizionari di Python (dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
Cosa candidarsi oggi
- Preferire sempre un dizionario/mappa hash per le ricerche chiave-valore ricerca su un elenco di coppie. La differenza di prestazioni tra O(1) e O(n) è enorme su set di dati di grandi dimensioni.
- Prestare attenzione all'ordine dei dati quando le prestazioni sono importanti. Come si vede con gli alberi binari di ricerca, l'inserimento di dati ordinati in determinate strutture può innescare il comportamento peggiore.
- Chiedi se i tuoi dati devono essere ordinati. Se hai bisogno solo di ricerche rapide e test di appartenenza, un set (basato su hash) è molto più efficiente di un elenco.
- Visualizza le operazioni sottostanti. Quando uno script è lento, pensa se stai forzando un'operazione lineare O(n) all'interno di un ciclo, creando inavvertitamente una complessità O(n²).
- Riconoscere il compromesso spazio-tempo. Una tabella hash (come una tabella Python
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
Chiusura
Il tema centrale è che ogni struttura dati rappresenta un compromesso tra tempo, spazio e complessità di implementazione. Non esiste una struttura "migliore", ma solo quella più appropriata per il compito da svolgere. La lezione si sposta poi su Python, un linguaggio che astrae molti dei dettagli di gestione manuale della memoria di cui abbiamo parlato. Tuttavia, i principi di prestazione rimangono altrettanto critici, poiché queste strutture operano ancora in modo indiretto. Quale struttura dati che usate ogni giorno ora considererete in modo diverso?





