


Il vantaggio di SQL per le query sui dati
Questa guida mostra agli analisti e agli scienziati dei dati come i principi fondamentali di SQL possano creare pipeline di dati più veloci, più robuste e più facili da gestire rispetto agli script Python generici.
Introduzione: il costo nascosto del “semplicemente scorrere”
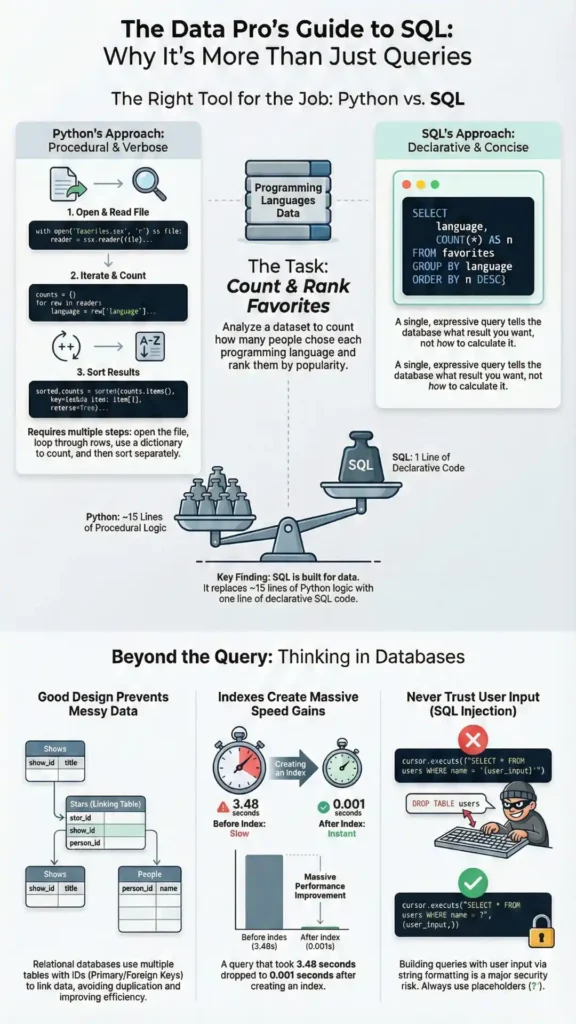
Per molti esperti di dati, l'approccio predefinito per un nuovo file CSV è scrivere uno script Python. Apriamo il file, eseguiamo un ciclo tra le righe e creiamo manualmente contatori o elenchi per rispondere a quelle che sembrano domande semplici. Sebbene funzioni, spesso porta a un codice lento e fragile, difficile da manutenere. Alcune colonne riordinate nel file sorgente possono compromettere l'intero script. Rispondere a una domanda leggermente diversa significa riscrivere cicli e istruzioni condizionali complessi. Questo approccio imperativo e graduale nasconde un modo più potente, elegante ed efficiente di lavorare con i dati. Adottando un linguaggio specializzato, possiamo esprimere domande complesse più facilmente e sostituire 17 righe di Python fragile con una singola riga dichiarativa di SQL.
Conclusione 1: Rendi robusta l'acquisizione dei dati
Una delle vulnerabilità più comuni in un semplice script di dati Python è l'accesso alle colonne CSV tramite il loro indice numerico, come row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
Una soluzione più robusta è quella di utilizzare il codice integrato di Python csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
Collegamento della scienza dei dati: questa pratica rende le pipeline di acquisizione dati significativamente più resilienti alle modifiche nei file di origine. Riduce i bug imprevisti, minimizza la manutenzione e garantisce che i risultati analitici siano basati sulle colonne di dati corrette, migliorando l'affidabilità dell'intero flusso di lavoro.
Takeaway 2: Il cambiamento di mentalità dichiarativa
Una differenza fondamentale tra Python e SQL è il paradigma di programmazione che incoraggiano. Python è principalmente imperativo—dillo al computer come per ottenere una risposta passo dopo passo. Per contare i linguaggi di programmazione preferiti da un file CSV, l'approccio Python prevede l'inizializzazione delle variabili contatore, l'apertura di un file, l'esecuzione di un ciclo su ogni riga e l'utilizzo if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
SQL, al contrario, è dichiarativo—tu dichiari che cosa La risposta che cerchi, e il motore del database trova il modo più efficiente per ottenerla. La stessa operazione di conteggio in SQL è una singola istruzione: SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
Collegamento della scienza dei dati: Pensare in modo dichiarativo permette agli analisti di esprimere quesiti complessi sui dati in modo più diretto e con meno possibilità di errori logici. Invece di costruire intricati cicli procedurali, ci si può concentrare sulla definizione dei dati necessari, ottenendo query più chiare, leggibili e accurate.
“…sembra che stiamo spendendo un sacco di tempo a sviluppare tutto questo quando sarebbe bello se potessimo semplificare questo codice… sarebbe bello poter rispondere a questa domanda molto velocemente…” — Harvard CS50x 2025 (YouTube) — Lezione: SQL
Conclusione 3: la buona forma dei dati non è casuale
La struttura dei dati influisce notevolmente sulla capacità di analizzarli correttamente ed efficientemente. Un errore comune, illustrato da un foglio di calcolo per la serie TV "The Office", è quello di archiviare in modo inadeguato i dati correlati. Una cattiva progettazione prevede l'aggiunta di una nuova colonna per ogni stella (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
La soluzione è un concetto di database di base chiamato normalizzazioneInvece di una tabella disordinata, si suddividono i dati in tabelle distinte per entità distinte. Ad esempio, si crea una shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id e person_id).
Questo design elimina la ridondanza sostituendo lunghe stringhe di testo di lunghezza variabile come "The Office" con piccoli interi di dimensione fissa (ad esempio, un ID a 32 o 64 bit). Questo approccio consente di risparmiare spazio significativo e migliorare le prestazioni.
Collegamento della scienza dei dati: la normalizzazione fornisce un potente modello mentale per la pulizia e la strutturazione dei dati. Riconoscere e correggere la ridondanza in set di dati disordinati (come i fogli di calcolo) aiuta a prevenire errori analitici e garantisce che aggregazioni e join producano risultati corretti. È un passaggio fondamentale nella preparazione dei dati per un'analisi affidabile.
Conclusione 4: la correzione delle prestazioni in una sola riga
Le query lente rappresentano un importante collo di bottiglia nell'analisi dei dati, soprattutto su dataset di grandi dimensioni con relazioni complesse. Ad esempio, una query che univa tre tabelle per trovare tutti i programmi TV di Steve Carell ha impiegato ben 3.483 secondi per essere eseguita durante la lezione. Questo ritardo si verifica perché, senza guida, il database esegue una ricerca lineare, controllando ogni singola riga di una tabella per trovare corrispondenze.
La soluzione è creare un INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
Lo svantaggio è che gli indici consumano più spazio di archiviazione e possono rallentare leggermente le operazioni di scrittura (INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
Collegamento della scienza dei dati: Comprendere gli indici offre agli esperti di dati uno strumento semplice ed efficace per contrastare i colli di bottiglia prestazionali. Quando si riscontrano query lente su grandi set di dati, la creazione di un indice sulle colonne filtrate è spesso il primo e più efficace passo per l'ottimizzazione.
Conclusione 5: Smetti di fidarti dell'input dell'utente
La creazione di query inserendo direttamente l'input dell'utente in una stringa, ad esempio con le f-string di Python, crea una grave vulnerabilità di sicurezza nota come attacco di SQL injection. Questo si verifica quando un utente malintenzionato fornisce un input che viene eseguito come parte del comando SQL stesso.
L'esempio classico riguarda un modulo di login. Se il codice costruisce una query come f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
La soluzione è sempre uso query parametrizzateInvece di usare le stringhe f, si usa un segnaposto (come ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
Collegamento della scienza dei dati: questa è una pratica di sicurezza fondamentale per chiunque sviluppi applicazioni interattive per la gestione dei dati, dashboard o qualsiasi strumento che interroghi un database in base a filtri o input forniti dall'utente. La mancata parametrizzazione delle query espone i dati e i sistemi a rischi significativi.
Cosa candidarsi oggi
- Quando si legge un CSV in Python, utilizzare
csv.DictReaderinstead of accessing columns by number. - Prima di scrivere un ciclo Python per aggregare i dati, chiediti: "Potrebbe essere un singolo
GROUP BYquery in SQL?” - Se vedi lo stesso valore di testo ripetuto più volte in un foglio di calcolo, valuta la possibilità di dividere i dati in due tabelle collegate da un ID univoco.
- Se un
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - Non utilizzare mai f-string o concatenazioni di stringhe per aggiungere input utente a una query SQL. Utilizzare sempre segnaposto.
Chiusura
Sebbene sia facile utilizzare un linguaggio generico come Python per ogni attività, questa lezione di CS50 dimostra che i concetti fondamentali dell'informatica offrono vantaggi pratici e significativi per l'analisi dei dati. Questa lezione è solo una parte di una serie completa che dimostra come gli argomenti fondamentali dell'informatica migliorino direttamente la qualità e l'efficienza dell'analisi dei dati. Adottando la natura dichiarativa di SQL, i solidi principi di modellazione dei dati e le sue prestazioni, i professionisti dei dati possono scrivere codice non solo più veloce, ma anche più robusto e facile da comprendere.
Qual è un'operazione di routine sui dati che esegui in Python che potrebbe essere sostituita da una singola query SQL dichiarativa ? query invece?





