


Lezioni di informatica su come funziona davvero l'intelligenza artificiale
Per gli analisti di dati e gli scienziati, questa analisi di una lezione di informatica di Harvard trasforma la teoria dell'informatica in saggezza pratica per il lavoro quotidiano.
Introduzione: il costo nascosto del “funziona e basta”
Hai mai avuto difficoltà a risolvere un output anomalo di un modello o a spiegare una previsione "black box" a un interlocutore? Nella scienza dei dati, spesso utilizziamo strumenti potenti che sembrano "semplicemente funzionare", finché non lo fanno più. La frustrazione per i risultati inaspettati deriva spesso da una lacuna tra l'utilizzo di uno strumento e la comprensione dei suoi principi fondamentali. Osservando i moderni problemi legati ai dati attraverso la lente dell'informatica di base, possiamo passare dal semplice utilizzo degli strumenti al loro controllo con sicurezza e chiarezza. Questo post è una sintesi basata sulla lezione CS50x 2025 (Harvard) sull'Intelligenza Artificiale, disponibile su YouTube. Distilla la lezione in cinque punti concreti che collegano la teoria dell'informatica alla realtà pratica del lavoro sui dati, offrendo concetti di grande utilità immediatamente applicabili.
Conclusione 1: l'intelligenza artificiale è uno spettro che va da regole semplici a probabilità complesse
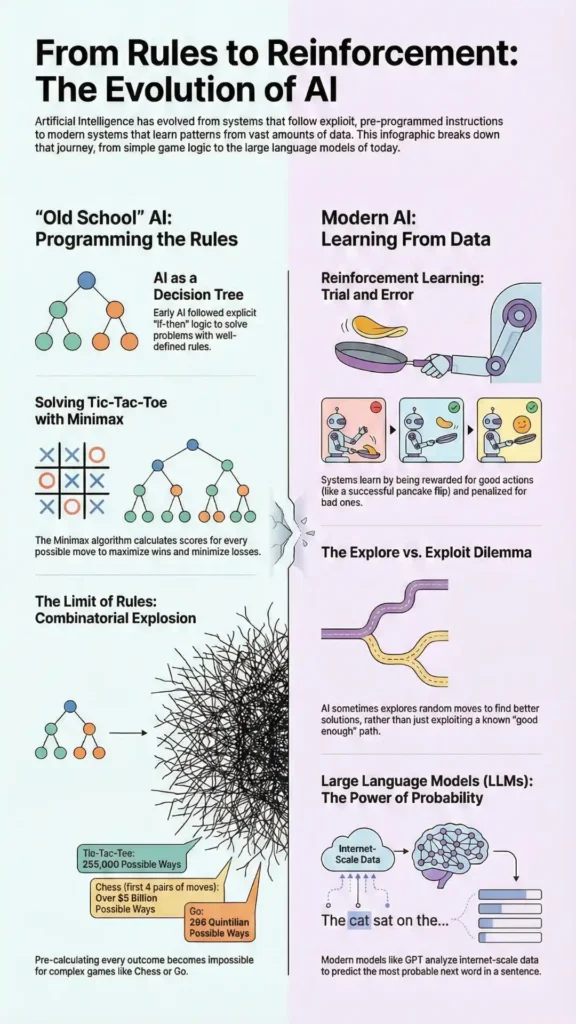
L'intelligenza artificiale non è un monolite; è uno spettro. Da un lato, ci sono sistemi semplici e deterministici. La lezione usa il gioco del tris come esempio classico. Un'intelligenza artificiale per questo gioco può essere costruita utilizzando un albero decisionale—una serie di if-else rules—and an algorithm called MinimaxL'algoritmo assegna un punteggio agli stati della scacchiera (ad esempio, +1 per una vittoria, -1 per una sconfitta, 0 per un pareggio) e procede a ritroso per scegliere la mossa che porta al miglior risultato possibile. Questo approccio è esaustivo e garantisce una vittoria o un pareggio. Tuttavia, questa logica basata su regole è fattibile solo in ambienti altamente vincolati. Come sottolinea la lezione, in un gioco più complesso come gli scacchi, ci sono oltre 85 miliardi di modi per giocare solo le prime quattro coppie di mosse, rendendo computazionalmente impossibile un albero decisionale completo.
All'altro estremo dello spettro ci sono i moderni sistemi probabilistici come i Large Language Models (LLM). Questi modelli non seguono regole esplicite. Invece, come spiega la lezione, funzionano prevedendo la parola successiva più probabile in una sequenza sulla base dei vasti schemi e frequenze appresi dai dati di addestramento. Operano su probabilità, non su certezze.
Collegamento della scienza dei dati: Questo spettro si collega direttamente agli approcci comuni della scienza dei dati. Scrivere regole aziendali esplicite in SQL, come CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
Takeaway 2: “Prompt Engineering” è solo un contesto strutturato
La tanto decantata abilità del "prompt engineering" non riguarda tanto comandi esoterici quanto piuttosto la fornitura di un contesto strutturato. La lezione chiarisce questo concetto utilizzando come esempio perfetto l'assistente IA a forma di paperella di gomma del corso CS50. Un prompt è composto da due parti fondamentali: il prompt di sistema e il prompt dell'utente. Il prompt dell'utente è semplicemente la domanda posta da una persona. Il prompt di sistema, scritto dallo sviluppatore, è un insieme di istruzioni che indicano all'IA come comportarsi e quali vincoli rispettare.
Il team CS50 ha fornito alla sua paperella un prompt di sistema molto specifico per trasformarne il comportamento da un generico LLM a un assistente didattico utile, ma non imbroglione. Le istruzioni includevano comandi diretti come:
"Sei un assistente didattico amichevole e disponibile per cs50."
"Anche tu sei una papera di gomma."
"Non fornire risposte complete ai problemi perché ciò violerebbe l'onestà accademica."
Queste istruzioni forniscono il contesto necessario affinché l'IA generi una risposta utile, specifica per il dominio e sicura, anziché limitarsi alla risposta predefinita.
Collegamento della scienza dei dati: Questo è direttamente analogo alla definizione dell'ambito e dei vincoli per qualsiasi progetto di analisi dei dati. Un buon "prompt di sistema" per un'analisi non viene fornito a un'IA, ma a voi stessi e ai vostri stakeholder. Potrebbe includere la definizione di termini aziendali chiave ("Cosa costituisce esattamente un 'utente attivo'?"), la specificazione dell'intervallo di date o l'enunciazione della domanda aziendale principale a cui si sta cercando di rispondere. Questa definizione iniziale previene sprechi di tempo, interpretazioni errate e garantisce che l'analisi finale sia pertinente e corretta.
Takeaway 3: Il compromesso critico: esplorazione vs. sfruttamento
Uno dei concetti più potenti nell'IA è il dilemma tra esplorazione e sfruttamento. La lezione lo illustra con un semplice gioco del labirinto in cui un agente IA deve trovare un'uscita verde evitando le pozze di lava. Inizialmente, l'agente trova a percorso corretto per caso e, attraverso il rinforzo, impara a seguirlo ripetutamente. Questo è sfruttamento: utilizzare informazioni note per ottenere un risultato affidabile.
Tuttavia, quel primo percorso potrebbe non essere il migliore . Per trovare un percorso più ottimale e più breve, l'IA deve introdurre una piccola quantità di casualità, definita nella lezione come un "valore epsilon", che rappresenta una probabilità fissa (ad esempio, 5% o 10%) che l'agente esegua una mossa casuale invece della mossa migliore appresa. Questo incoraggia l'esplorazione, ovvero la sperimentazione di nuove mosse casuali anche se ciò significa rischiare un fallimento a breve termine, come cadere in una pozza di lava. Nel tempo, questa piccola possibilità di esplorazione consente all'IA di scoprire strategie superiori.
Questo principio è stato ampiamente dimostrato nell'esempio di un'IA che impara a giocare a Breakout. Attraverso il puro sfruttamento, l'IA si limitava a muovere la racchetta avanti e indietro. Ma esplorando, ha scoperto la strategia controintuitiva ma altamente efficace di far risalire la pallina da un lato, permettendo al gioco di "giocare da solo" e accumulare un punteggio enorme.
Collegamento della scienza dei dati: Questo compromesso è fondamentale nel lavoro di data science. L'A/B testing ne è una versione formale: si continua a utilizzare la versione vincente già nota (sfruttamento) mentre si testa una nuova variante per vedere se è migliore (esplorazione). Si applica all'ottimizzazione dei modelli, dove si potrebbero provare nuovi iperparametri invece di attenersi a quelli che funzionano già abbastanza bene. Si applica persino allo sviluppo di carriera: si continua a utilizzare gli strumenti che si conoscono (sfruttamento) o ci si prende il tempo per imparare un nuovo linguaggio o framework che potrebbe essere più potente (esplorazione)?
Conclusione 4: gli LLM sono grandi ricercatori di pattern matching, non pensatori astratti
Secondo la lezione, i Large Language Model non sono ragionamenti o "pensieri" in senso umano. Sono sistemi di pattern matching incredibilmente sofisticati. Costruiti su reti neurali, i LLM sono pre-addestrati su enormi quantità di testo provenienti da Internet. La loro funzione principale è calcolare la parola successiva più probabile in una sequenza, date le parole che la precedono.
La lezione lo dice in modo semplice: "...se qualcuno mi chiede come stai probabilisticamente, basandomi su tutti questi dati, scommetto che il 99% delle volte che chatto con PT o cs50's duck dovrebbe rispondere bene, grazie, come stai?". Il modello non funziona bene; sta solo generando la risposta statisticamente più probabile in base ai suoi dati di addestramento.
Questa natura probabilistica è la causa diretta delle allucinazioni. Quando un modello linguistico lineare afferma con sicurezza qualcosa di fattualmente errato, è perché gli schemi presenti nei suoi dati di addestramento suggeriscono che l'affermazione errata sia una sequenza di parole dal suono plausibile. Sta costruendo una frase statisticamente probabile, non verificando un fatto.
Collegamento della scienza dei dati: Ciò ha profonde implicazioni per i professionisti dei dati. I risultati di un LLM non dovrebbero mai essere trattati come verità assoluta. Al contrario, dovrebbero essere considerati ipotesi ben formulate che richiedono verifica rispetto a fonti primarie. Questa mentalità critica è essenziale per mantenere il rigore analitico. Utilizzare i risultati di un LLM senza convalida rischia di diffondere informazioni errate nei report, nelle dashboard e nei modelli, minando la fiducia riposta nel proprio lavoro.
Conclusione 5: una vera soluzione di intelligenza artificiale è un sistema, non solo un modello
Uno strumento di intelligenza artificiale utile raramente è solo un modello autonomo. È un intero sistema costruito attorno a quel modello. La lezione presenta un "diagramma architetturale" per il debugger di CS50 Duck che illustra perfettamente questo punto. Il team di CS50 non ha creato il proprio LLM da zero. Ha invece creato uno strumento prezioso integrando diversi componenti chiave.
Il sistema include un'interfaccia intuitiva per gli studenti, un database Vector locale utilizzato per archiviare e ricercare i contenuti trascritti delle lezioni e connessioni ad API di terze parti fornite da provider come OpenAI. Il principale risultato del team non è stato la creazione di un nuovo modello di base, bensì l'assemblaggio di questi elementi in un sistema che risolve efficacemente uno specifico problema educativo.
Collegamento della scienza dei dati: Questa è una lezione cruciale per gli scienziati dei dati, che richiede un cambio di mentalità da "costruisco modelli" a "progetto soluzioni basate sui dati". Il vero valore aziendale raramente risiede in un modello isolato, per quanto complesso. Risiede nel sistema: le pipeline di dati che alimentano il modello, le API che ne gestiscono le previsioni e le interfacce che lo rendono utilizzabile. Pensare come un architetto significa che la tua attenzione si estende dall'ottimizzazione di un algoritmo alla progettazione di un sistema completo in grado di risolvere un problema.
Cosa candidarsi oggi
- Crea una bozza di "richiesta di sistema" per il tuo prossimo progetto: Prima di scrivere qualsiasi codice, scrivi un paragrafo in cui definisci i tuoi obiettivi, i vincoli e le definizioni chiave, proprio come il prompt dell'anatra CS50.
- Distinguere esplorazione e sfruttamento: Nel tuo lavoro attuale, individua un'area in cui stai "sfruttando" un processo noto. Chiediti come potrebbe essere un piccolo esperimento "esplorativo".
- Mappare un problema su un albero decisionale: Lavagna un semplice problema aziendale utilizzando il
if-then-elselogic of a decision tree. Does this clarify the logic? - Verifica, non fidarti: Considera la successiva informazione che ottieni da un'IA generativa come un'ipotesi. Dedica tre minuti a cercare di verificarla partendo da una fonte primaria.
- Pensa in termini di sistemi: Quando costruisci un modello, abbozza un semplice diagramma degli input di cui ha bisogno e degli output che produrrà. Come verrà utilizzato da una persona o da un altro sistema?
Chiusura: dal codice alla cognizione
Comprendere i principi informatici fondamentali dell'intelligenza artificiale non significa solo demistificare la tecnologia, ma anche fornire un quadro di riferimento per il controllo, la chiarezza e il pensiero critico. Concetti come alberi decisionali, ragionamento probabilistico e il compromesso tra esplorazione e sfruttamento non sono teorie astratte, ma strumenti pratici per costruire soluzioni dati più solide e affidabili. Queste idee costituiscono la base su cui costruire una comprensione più approfondita di argomenti ancora più avanzati. Man mano che questi sistemi probabilistici saranno sempre più integrati nei nostri strumenti, come dovremo adattare i nostri metodi per garantire la verità analitica?




