


Guida per data scientist al CS50x: punti chiave del corso di informatica fondamentale di Harvard
Introduzione: perché i fondamenti dell'informatica sono importanti per il lavoro sui dati
Per chi lavora analisi dei dati, nella scienza dei dati e nella statistica, il percorso verso la competenza spesso si snoda attraverso corsi di modellazione, visualizzazione e strumenti specifici del settore. Eppure, al di là delle librerie e dei framework di alto livello che utilizziamo quotidianamente, si cela un solido fondamento di informatica. Comprendere questi principi cardine – come i dati vengono memorizzati in memoria, perché una struttura dati è più veloce di un'altra e come i dati si spostano da un server back-end al browser dell'utente – non è solo un esercizio accademico. È un vantaggio pratico che ci permette di scrivere codice più efficiente, costruire pipeline di dati più robuste e creare prodotti dati più sofisticati.
Questa guida è una sintesi del corso di informatica fondamentale di Harvard, CS50x 2025, basata sulle lezioni disponibili pubblicamente su YouTube. Il suo scopo è quello di estrarre i concetti e le competenze più rilevanti dal corso e presentarli a un pubblico di professionisti dei dati, attuali e aspiranti.
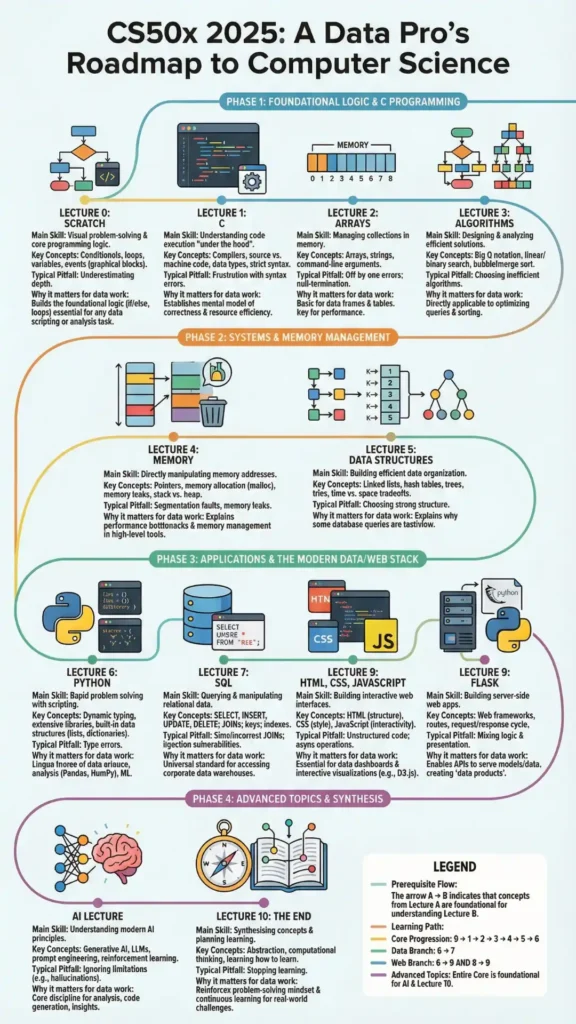
1. Il percorso CS50x: una panoramica in tre fasi per i professionisti dei dati
Il curriculum CS50x può essere visto come un percorso in tre fasi, che parte dai fondamenti di base per arrivare alle astrazioni di alto livello e, infine, allo sviluppo di applicazioni full-stack. Ogni fase sviluppa competenze direttamente applicabili ai ruoli incentrati sui dati.
1.1. Fase 1: Fondamenti in C (Lezioni 0-5)
Il corso non inizia con un linguaggio convenzionale, bensì con l'ambiente di programmazione visuale Scratch, per poi passare rapidamente al linguaggio C. Questa fase iniziale è dedicata ai concetti fondamentali della programmazione, alla gestione manuale della memoria (Lezione 4) e alle strutture dati di base come tabelle hash, alberi e try (Lezione 5). Per un professionista dei dati, lavorare con un linguaggio di basso livello come il C sviluppa una cruciale "empatia meccanica", ovvero una comprensione intuitiva di come i dati vengono memorizzati, indirizzati e manipolati a livello fondamentale. Questa conoscenza è preziosa per diagnosticare i colli di bottiglia delle prestazioni e scrivere codice ottimizzato, anche in linguaggi di alto livello come Python.
1.2. Fase 2: Astrazione e strumenti moderni (Lezione 6 e 6.5)
Questa fase segna una transizione fondamentale verso Python, che il corso presenta come un linguaggio di alto livello, "batterie incluse". La Lezione 6 illustra in modo efficace questo cambiamento reimplementando programmi C complessi, come un correttore ortografico e filtri per immagini, in poche righe di Python, sfruttando il suo ricco ecosistema di librerie. Questo rispecchia direttamente l'affidamento del data scientist all'ecosistema Python (Pandas, NumPy, Scikit-learn). Il corso si addentra poi nell'Intelligenza Artificiale (Lezione 6.5), coprendo un ampio spettro di argomenti, dai concetti fondamentali come gli alberi decisionali e l'apprendimento per rinforzo alle applicazioni moderne come i Large Language Model (LLM) e l'ingegneria dei prompt.
1.3. Fase 3: Lo stack di dati e Web (lezioni 7-9)
La fase finale del corso si concentra sull'integrazione di queste competenze per creare applicazioni complete basate sui dati. Questa sezione tratta la gestione e l'archiviazione dei dati, ad esempio nei file CSV utilizzati negli esempi delle lezioni, e l'utilizzo del framework Flask per creare applicazioni web dinamiche in grado di interagire con tali dati (Lezione 9). Questa fase funge da pietra miliare, insegnando ai professionisti dei dati come andare oltre script e analisi standalone. Fornisce le competenze per creare interfacce in cui i dati possono essere archiviati, recuperati e presentati agli utenti finali tramite un front-end web personalizzato, trasformando un'analisi o un modello in un prodotto dati utilizzabile.
2. 10 spunti di grande utilità per i professionisti dei dati
- Una base di basso livello C crea una mentalità performante: La gestione manuale della memoria in C, un argomento in contrasto con la gestione automatica della memoria in Python nella Lezione 6, impone la comprensione del costo computazionale. Questo sviluppa un'intuizione sulle prestazioni che aiuta i professionisti dei dati a scrivere codice Python più efficiente e a riconoscere perché alcune operazioni sono più costose di altre.
- Le strutture dati sono strumenti pratici, non solo teoria: Come discusso nella Lezione 5, comprendere i "vantaggi e gli svantaggi" di strutture come le tabelle hash è direttamente applicabile al lavoro sui dati. Questa conoscenza teorica orienta le decisioni pratiche, come la scelta di un linguaggio Python.
setodictfor O(1) average-time complexity lookups during feature engineering, which is vastly more performant than an O(n) search through a list when deduplicating millions of records. - Il vero potere di Python è il suo ecosistema di librerie: La lezione 6 illustra come implementare filtri per le immagini e un correttore ortografico in una frazione del tempo e del codice richiesti in C. Questo evidenzia come il vasto ecosistema di librerie di Python, lo stesso ecosistema che include Pandas, NumPy e Matplotlib, sia il vero motore della produttività nella scienza dei dati.
- Formazione Come Imparare è l'abilità suprema: Uno degli obiettivi dichiarati della Lezione 6 è quello di fornire agli studenti la capacità di "imparare da soli un nuovo linguaggio" partendo da C e passando a Python. Per i professionisti dei dati in un campo in rapida evoluzione, questa meta-abilità è essenziale per rimanere aggiornati su nuovi strumenti, framework e tecnologie.
- Adotta la gestione degli errori Pythonic per pipeline resilienti: Il corso mette a confronto l'affidamento del C su valori di ritorno speciali per segnalare gli errori con quelli più espressivi di Python
try...exceptblocks (Lecture 6). This exception-handling model is far superior for building robust and debuggable data pipelines that can gracefully handle unexpected issues without failing silently. - Le API sono la porta d'accesso alle moderne applicazioni di dati: Il chatbot di intelligenza artificiale con codice live della Lezione 6.5, che utilizza l'API OpenAI, dimostra una competenza moderna fondamentale. La competenza con le API è essenziale per accedere a set di dati di terze parti, utilizzare modelli di apprendimento automatico basati su cloud e integrare informazioni basate sui dati in applicazioni software più ampie.
- La logica lato server è il modo in cui si passa dall'analisi all'applicazione: Gli esempi Flask della Lezione 9 mostrano come un framework back-end funga da ponte tra una fonte dati (come un file CSV o un database) e un utente. Questa è la competenza chiave che consente ai professionisti dei dati di creare dashboard interattive, interfacce per modelli di apprendimento automatico e altri prodotti dati che vanno oltre un report statico.
- La convalida lato server protegge l'integrità dei dati: La Lezione 9 sottolinea che la convalida lato client è una comodità per l'utente, non una misura di sicurezza, e può essere facilmente aggirata. L'applicazione di regole e controlli sulla qualità dei dati sul server è un principio fondamentale per mantenere l'integrità e l'affidabilità di qualsiasi set di dati. Questa è la prima linea di difesa per la qualità dei dati, impedendo che voci malformate o non valide contaminino i dati di training o interrompano un modello a valle.
- La creazione di modelli separa l'analisi dalla presentazione: Il corso dimostra come il motore di template Jinja in Flask utilizza una logica semplice come
{% for sport in sports %}to dynamically generate HTML (Lecture 9). This principle of separating logic from presentation is directly applicable to creating scalable data reports and dashboards, where the visual layer automatically adapts to changes in the underlying data. - Comprendere i fondamenti dell'intelligenza artificiale sfata il clamore: La lezione 6.5 offre una panoramica sui principi fondamentali di concetti come alberi decisionali, apprendimento per rinforzo e reti neurali. Questa conoscenza di base fornisce un modello mentale del funzionamento effettivo dei moderni strumenti di intelligenza artificiale, inclusi i master in ingegneria e matematica (LLM), consentendo a un data scientist di utilizzarli in modo più efficace, critico e consapevole dei loro limiti.
3. Percorsi di studio consigliati
3.1. Traccia 1: Il principiante (nuovo nella programmazione)
Destinatari: Persone con poca o nessuna esperienza di programmazione che desiderano acquisire una solida e completa base di conoscenze.
Raccomandazione:
- Seguire il corso in sequenza dalla lezione 0 alla lezione 9.
- Non saltare le lezioni di C: il pensiero rigoroso e di basso livello è prezioso per acquisire una comprensione approfondita del funzionamento dei computer.
- Prestate molta attenzione alla transizione da C a Python nella Lezione 6, poiché illustra chiaramente i compromessi e i vantaggi dei linguaggi di alto livello.
3.2. Traccia 2: Intermedio (Conosce una lingua, è nuovo all'informatica)
Destinatari: Professionisti (ad esempio, analisti che hanno familiarità con gli script Python/R) privi di una formazione formale in informatica.
Raccomandazione:
- Concentratevi soprattutto sulle Lezioni 4 (Memoria) e 5 (Strutture Dati). Questa è la teoria fondamentale dell'informatica, che offre la maggiore leva per scrivere codice performante e scalabile.
- Considerate la Lezione 6 (Python) come un ripasso, ma prestate particolare attenzione ai confronti con C per comprendere i compromessi nella progettazione del linguaggio.
- Date priorità alla lezione 9 (Flask) per imparare a strutturare un'applicazione full-stack, un'abilità che colma il divario tra la scrittura di script autonomi e la creazione di prodotti di dati.
3.3. Traccia 3: Aggiornamento per Data Scientist
Destinatari: Data scientist esperti che desiderano consolidare le proprie conoscenze di base e comprendere gli strumenti moderni.
Raccomandazione:
- Rivedere la Lezione 5 (Strutture dati) per rinfrescare le conoscenze sulle caratteristiche prestazionali dei diversi modi di organizzare i dati.
- Approfondisci la Lezione 6.5 (IA) per ottenere una chiara comprensione dei principi fondamentali della tecnologia alla base degli LLM e degli strumenti generativi ormai comuni nel settore.
- Concentratevi sulla Lezione 9 (Flask) come guida pratica per l'implementazione di modelli e la creazione di applicazioni di dati interattive, un'abilità fondamentale "dell'ultimo miglio" per generare valore.
Conclusione: dal codice all'artigianato
In definitiva, un corso come CS50x offre più di una semplice panoramica sui linguaggi e sui concetti di programmazione. Per il professionista dei dati, fornisce gli strumenti intellettuali per passare dall'essere un semplice utilizzatore di strumenti a un costruttore di soluzioni. I principi di gestione della memoria, delle strutture dati e dell'architettura full-stack non sono ostacoli accademici; sono leve dirette per creare prodotti basati sui dati più efficienti, robusti e preziosi. Investendo in queste basi, si passa dalla semplice analisi dei dati alla creazione di applicazioni basate sui dati con sicurezza e competenza.



