


Ciò che gli scienziati dei dati dimenticano sulla memoria
Una guida per analisti e scienziati dei dati per scrivere codice più robusto, efficiente e prevedibile, comprendendo il vero funzionamento della memoria.
Introduzione: i bug che non sono nella tua logica
Puoi Python script che funziona perfettamente su un piccolo campione di dati ma si blocca con un messaggio criptico MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
Molti di questi problemi imprevedibili e di alto livello affondano le radici in concetti fondamentali dell'informatica sulla memoria. Comprenderli non è solo un esercizio accademico; è un'abilità pratica per scrivere codice migliore e più affidabile. Questo post è una sintesi basata sulla lezione sulla memoria tenutasi al CS50x 2025 (Harvard), disponibile su YouTube.
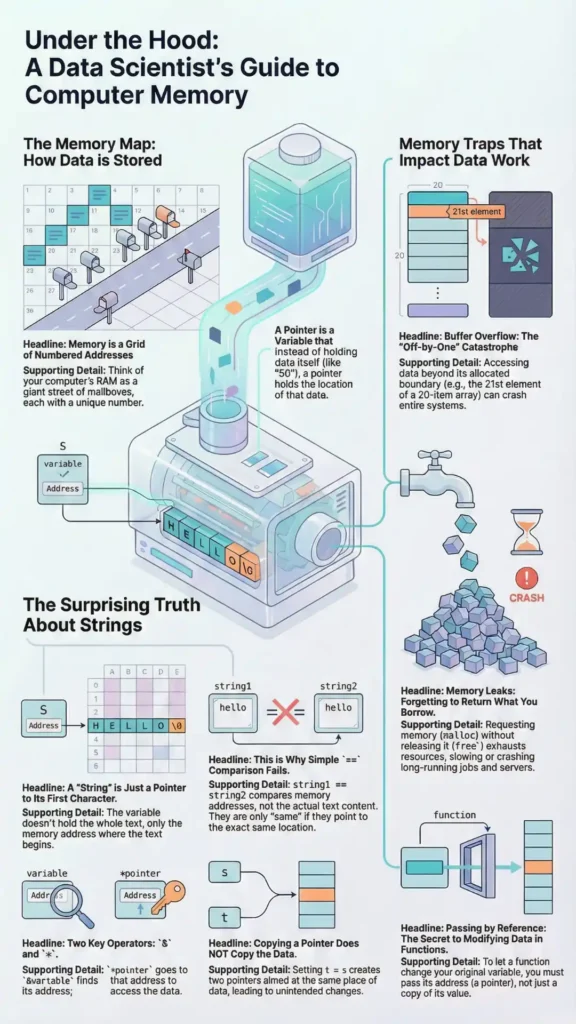
Takeaway 1: “String” è un’illusione
In molti contesti introduttivi, un string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
Ciò che chiamiamo una stringa è in realtà una char *—a pointer to a character. This pointer is simply the memory address of the primo carattere in una sequenza. Per sapere dove termina la stringa, C si basa su uno speciale valore sentinella: il terminatore nullo (\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
Collegamento della scienza dei dati: questo concetto è all'origine del modo in cui linguaggi di alto livello come Python e R gestiscono stringhe e altri dati a lunghezza variabile. Spiega perché la manipolazione delle stringhe può essere computazionalmente onerosa: il sistema spesso cerca un punto di terminazione o gestisce array sottostanti. Per gli scienziati dei dati, questo è fondamentale quando si analizzano file di testo non elaborati o si lavora con le API; un byte di terminazione mancante o errato può portare a dati corrotti o errori di analisi, come ad esempio la lettura errata di una riga di un file di log con conseguente troncamento di importanti informazioni di errore.
Takeaway 2: Perché == Can Lie About Equality
Quando si confrontano due variabili intere in C con ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory indirizzi.
Se hai due stringhe identiche, "high" e "high", ma sono memorizzate in posizioni diverse nella memoria, il == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
Collegamento della scienza dei dati: Questo è un parallelo diretto al concetto di identità dell'oggetto rispetto all'uguaglianza del valore in Python. Utilizzando is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
Conclusione 3: una copia potrebbe essere solo un alias
In C, un'istruzione come string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the indirizzo del primo carattere della stringa.
Ciò significa entrambe le variabili, s e t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
Collegamento della scienza dei dati: Questa è la radice del problema "vista vs. copia" che spesso confonde gli utenti di Pandas. Un data scientist potrebbe filtrare un DataFrame, assegnarlo a una nuova variabile e iniziare ad apportare modifiche, credendo di lavorare su una copia indipendente. Ma se Pandas restituisce una "vista" (un alias che punta ai dati originali), sta involontariamente modificando il dataset di origine. Ciò può portare a bug subdoli e pericolosi, difficili da individuare, poiché i dati originali vengono "misteriosamente" modificati da un'operazione eseguita altrove.
"Quando si usa letteralmente equals equals per confrontare due stringhe... cioè si confrontano le due stelle Char, cioè si confrontano i due indirizzi, chiaramente si trovano in posti diversi... avevamo bisogno di una soluzione per questo ed è per questo che abbiamo introdotto stir comp, la funzione che ha effettivamente risolto questo problema in modo appropriato." — Harvard CS50x 2025 (YouTube) — Lezione: Memoria
Conclusione 4: la memoria è una risorsa finita che devi gestire
Quando un programma ha bisogno di memoria durante l'esecuzione, ad esempio per memorizzare dati letti da un file, può richiederla al sistema operativo. In C, questo avviene con una funzione chiamata malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
Tuttavia, questa richiesta può fallire. Se il sistema non ha più memoria disponibile, malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
Collegamento della scienza dei dati: Questo è direttamente applicabile all'utilizzo di dataset di grandi dimensioni. Il tentativo di caricare un file CSV o Parquet di grandi dimensioni in un Pandas DataFrame può facilmente causare il crash di uno script se richiede più memoria di quella disponibile nel sistema. I principi di malloc e free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
Takeaway 5: Le funzioni hanno spazi di lavoro privati (The Stack)
Quando una funzione viene chiamata, ottiene il suo spazio di lavoro privato in una regione di memoria chiamata "stack". Questo "stack frame" contiene le sue variabili locali, inclusi gli argomenti che le vengono passati.
La lezione CS50 lo dimostra con un swap function intended to swap two integer values. The initial version fails because it only swaps copie dei valori all'interno del proprio stack frame privato. Questo è noto come "passaggio per valore". Una volta terminata la funzione, il suo stack frame scompare e le variabili originali nella funzione chiamante (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory indirizzi delle variabili originali. Questo dà il swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
Collegamento della scienza dei dati: Questo concetto è fondamentale per comprendere l'ambito delle variabili e la mutabilità quando si scrivono funzioni di trasformazione dei dati. Aiuta a spiegare perché una funzione potrebbe non modificare un DataFrame che le viene passato come previsto (ad esempio, se riassegna la variabile internamente invece di modificare l'oggetto direttamente). Sottolinea inoltre i principi di progettazione delle "funzioni pure", ovvero funzioni che non modificano i propri input, essenziali per creare pipeline di analisi riproducibili, testabili e prive di bug.
Takeaway 6: Il bug da un miliardo di dollari è un errore di uno
Un "buffer overflow" si verifica quando un programma tenta di scrivere dati oltre i limiti allocati di un buffer di memoria, come un array. È come cercare di versare un gallone d'acqua in un bicchiere da una pinta: l'eccesso deve andare da qualche parte e spesso sovrascrive la memoria adiacente, causando corruzione e crash.
La lezione fa riferimento a un incidente reale che ha coinvolto il software di sicurezza CrowdStrike. Un bug in un aggiornamento ha causato il blocco di sistemi in tutto il mondo. La causa principale era sorprendentemente semplice: il codice si aspettava un array con 20 valori, ma ne ha ricevuti 21. Il tentativo di accedere al 21° elemento inesistente ha prodotto una "lettura di memoria fuori dai limiti", che ha portato a un crash del sistema. Il linguaggio C non fornisce alcuna protezione automatica contro questo tipo di bug, il che lo rende un'efficace dimostrazione di una pericolosa classe di bug.
Collegamento della scienza dei dati: Questa è la lezione definitiva di programmazione difensiva per il lavoro con i dati. Quando si analizzano file, si itera su liste o si elaborano risposte API, non si può dare per scontato che i dati in ingresso siano conformi alle aspettative. Questa vulnerabilità di basso livello evidenzia l'importanza fondamentale di una gestione degli errori e di una validazione dell'input robuste. Aggiungete sempre controlli espliciti sui formati, le dimensioni e i limiti previsti prima di elaborare i dati, per evitare che l'intera pipeline si blocchi a causa di un valore inatteso.
Cosa applicare oggi: una checklist pratica
- Interroga i tuoi controlli di uguaglianza: Quando si confrontano oggetti complessi come modelli o DataFrame, fermarsi e confermare se è necessario sapere se sono esattamente lo stesso oggetto nella memoria (identità) o se semplicemente contengono gli stessi dati (uguaglianza). Utilizzare il metodo appropriato (
isvs..equals()) for your goal. - Verifica le modifiche al tuo DataFrame: Prima di modificare quella che ritieni essere una copia di un DataFrame, verifica esplicitamente se si tratta di una vista o di una copia. Una semplice modifica a una vista può danneggiare silenziosamente il dataset originale. Usa
.copy()to ensure you have an independent object. - Sii proattivo riguardo alla memoria: Quando si lavora con file di grandi dimensioni, non limitarsi a caricarli e sperare nel meglio. Utilizzare strumenti per verificare la memoria di sistema disponibile ed elaborare i file in blocchi più piccoli (ad esempio, utilizzando
chunksizeinpandas.read_csv) to avoid requesting more memory than is available. - Convalida dei limiti dei dati: Ogni volta che si accede ai dati tramite un indice, ad esempio in un elenco o in un array, bisogna considerarlo un potenziale punto di errore. Aggiungere controlli per garantire che l'indice rientri nell'intervallo previsto, soprattutto quando la dimensione dei dati è determinata da una fonte esterna.
- Non fidarti mai dei dati di input: Trattate i dati provenienti da file, API o input utente come fondamentalmente inaffidabili. Prima di eseguire operazioni, aggiungete asserzioni o controlli espliciti per tipi, dimensioni e formati di dati per individuare eventuali problemi imprevisti prima che compromettano l'analisi.
9. Pensieri di chiusura
Questi concetti di memoria di basso livello non sono solo banalità accademiche; emergono direttamente sotto forma di bug, colli di bottiglia nelle prestazioni e rischi per la sicurezza che incontriamo nel lavoro di data science di alto livello. Comprendendo cosa succede in memoria, possiamo passare dalla confusione dei sintomi alla diagnosi della causa principale. Con il progredire del corso CS50, questi stessi principi diventano i mattoni per creare le strutture dati efficienti che alimentano i nostri database e algoritmi.
Quale recente "strano" bug nel tuo codice potrebbe ora essere spiegato da uno di questi principi fondamentali della memoria?


