Cos'è l'analisi di regressione? Una guida completa per principianti
L'analisi di regressione è una tecnica statistica utilizzata per modellare la relazione tra la variabile dipendente e una o più variabili indipendenti, consentendo previsioni, processi decisionali e approfondimenti in vari campi.
Punti Salienti
- L'analisi di regressione modella le relazioni tra variabili dipendenti e indipendenti per la previsione e il processo decisionale.
- Lineare, logistica e polinomiale sono tipi chiave di regressione, ciascuno adatto a dati e obiettivi diversi.
- Le metriche di bontà di adattamento, come R-quadrato e R-quadrato corretto, valutano le prestazioni e la spiegabilità del modello.
- Le ipotesi di regressione includono linearità, normalità, indipendenza dagli errori e omoschedasticità, che devono essere convalidate.
- Le insidie comuni includono la correlazione confusa con la causalità, l’overfitting, la multicollinearità, la distorsione da variabili omesse e l’estrapolazione.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Cos'è l'analisi di regressione?
L'analisi di regressione è una tecnica fondamentale in statistica e nella scienza dei dati che ci permette di esplorare e quantificare le relazioni tra le variabili. Viene utilizzata per prevedere i risultati, identificare tendenzee prendere decisions basate sui dati in diversi settori, dal business e dalla finanza alla sanità e all'ingegneria.
In sostanza, l'analisi di regressione cerca di modellare la relazione tra una variabile dipendente (la variabile che stiamo cercando di prevedere o spiegare) e una o più variabili indipendenti (i fattori che influenzano la variabile dipendente). In questo modo, possiamo ottenere informazioni sui modelli sottostanti e sulle relazioni causali dei nostri dati, consentendoci di fare previsioni migliori e e più informate decisions.
L'idea fondamentale alla base dell'analisi di regressione è quella di trovare il modello che meglio rappresenta la relazione tra le variabili dipendenti e indipendenti. Ciò spesso implica l'adattamento di una retta o di una curva ai punti dati per minimizzare le differenze tra i valori osservati e quelli previsti, noti come residui.
In pratica, l'analisi di regressione può assumere molte forme, dalla semplice regressione lineare, che modella la relazione tra una variabile dipendente e una indipendente, a tecniche più avanzate, come la regressione polinomiale multipla, che consentono l'analisi di relazioni più complesse.
Come un'analisi versatile e potente L'analisi di regressione, strumento statisticoversatile e potente , è fondamentale per chiunque desideri interpretare i dati e trarne conclusioni significative. In questa guida, scoprirai i vari tipi dell'analisi di regressione, il loro fondamentale concettifondamentali , ipotesi e i limitiprincipali , nonché le applicazioni pratiche in diversi settori. Comprendendo cos'è l'analisi di regressione e padroneggiandone le tecniche, sarai in grado di affrontare complesse sfide legate ai dati e prendere decisioni basate sui dati con sicurezza.
Tipi di analisi di regressione
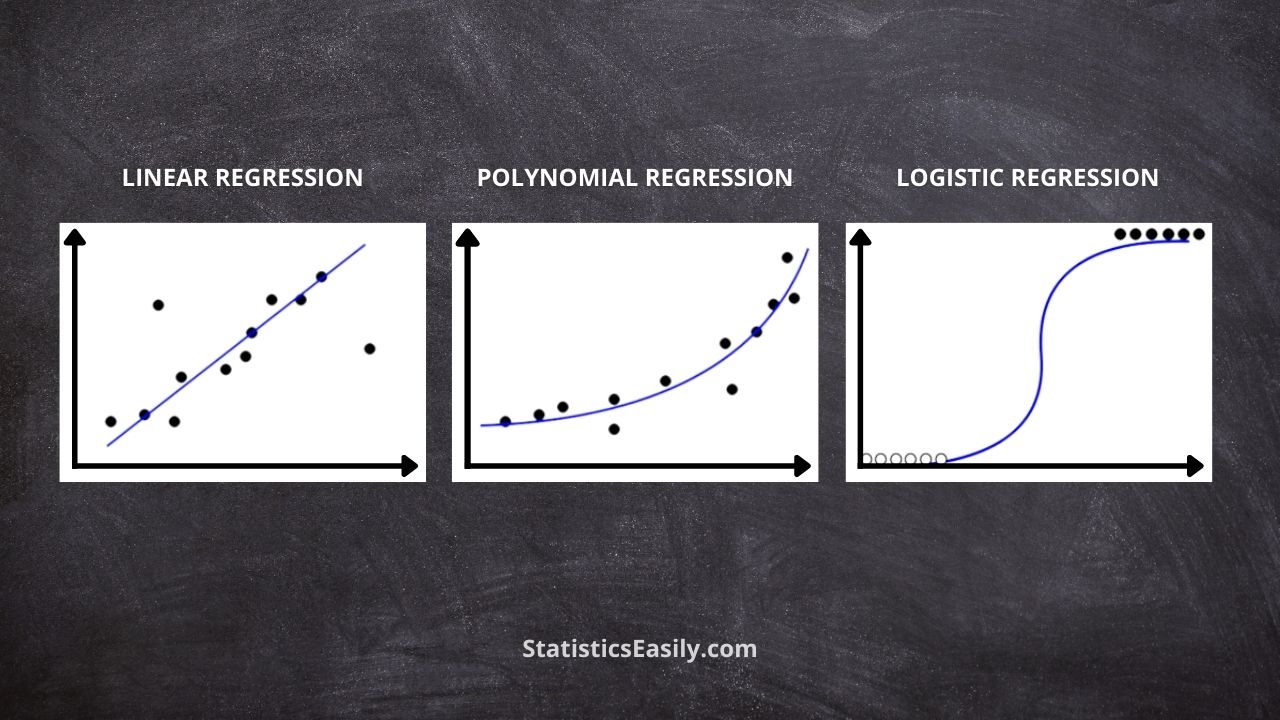
Regressione lineare:Questa è la forma più semplice di analisi di regressione per modellare la relazione tra variabili dipendenti e indipendenti. Presuppone una relazione lineare tra le variabili, rappresentata da una retta. L'obiettivo è trovare la retta che meglio approssima i dati, minimizzando la somma dei quadrati delle differenze tra i valori osservati e quelli previsti. La regressione lineare è ampiamente utilizzata per le previsioni, l'analisi delle tendenze e l'identificazione dell'impatto di una variabile su un'altra.
Regressione logistica:Si tratta di un tipo di analisi di regressione progettata per problemi con variabili dipendenti categoriche, incluse quelle binarie (due possibili risultati), nominali (categorie non ordinate) e ordinali (categorie ordinate). Anziché prevedere il valore effettivo della variabile dipendente, la regressione logistica stima la probabilità che un evento si verifichi in base alla variabile indipendente. Utilizza la funzione logistica, che trasforma l'output del modello di regressione in un valore di probabilità compreso tra 0 e 1. Comunemente utilizzata in campi come la ricerca medica, il marketing e la finanza, la regressione logistica è versatile per prevedere la probabilità di eventi o risultati specifici e per comprendere l'impatto di vari fattori su tali risultati.
Regressione polinomiale:Si tratta di un'estensione della regressione lineare, utilizzata quando la relazione tra le variabili dipendenti e indipendenti non è lineare. Invece di adattare una retta, si utilizza una funzione polinomiale per modellare la curvatura della relazione. La regressione polinomiale può catturare modelli più complessi nei dati, fornendo un adattamento migliore in situazioni in cui i modelli lineari risultano inadeguati. Tuttavia, è fondamentale prestare attenzione alla scelta del grado del polinomio, poiché modelli eccessivamente complessi possono portare all'overfitting e a una scarsa generalizzazione di nuovi dati.
*Regressione multipla: La regressione multipla è una tecnica avanzata che consente l'inclusione di più variabili indipendenti, permettendo l'analisi di relazioni più complesse tra le variabili e il controllo dei fattori confondenti. Non è solo una generalizzazione della regressione lineare, ma può essere estesa anche ad altri tipi di regressione, come la regressione logistica e polinomiale. L'obiettivo della regressione multipla è trovare il modello che meglio spiega la relazione tra le variabili dipendenti e indipendenti.
I concetti fondamentali dell'analisi di regressione
Variabili dipendenti e indipendenti:nell'analisi di regressione, la variabile dipendente (la variabile di risposta o obiettivo) è il risultato che cerchiamo di prevedere o spiegare. Allo stesso tempo, le variabili indipendenti (note anche come predittori, caratteristiche o variabili esplicative) sono i fattori che influenzano la variabile dipendente. L'analisi di regressione mira a modellare la relazione tra queste variabili, consentendoci di comprendere gli effetti delle variabili indipendenti sulla variabile dipendente e di fare previsioni.
Coefficienti e intercette:i coefficienti e le intercette sono componenti essenziali di un modello di regressione. I coefficienti rappresentano l'effetto delle variabili indipendenti sulla variabile dipendente, indicando di quanto cambia la variabile dipendente per ogni incremento unitario delle variabili indipendenti, supponendo che tutte le altre variabili rimangano costanti. L'intercetta rappresenta il valore atteso della variabile dipendente quando tutte le variabili indipendenti sono pari a zero. Questi valori vengono stimati utilizzando tecniche di stima dei minimi quadrati ordinari o di massima verosimiglianza durante la fase di adattamento del modello.
La bontà dell'adattamento e l'R-quadro: la bontà dell'adattamento misura quanto bene il modello di regressione si adatta ai dati osservati. Diverse metriche possono essere utilizzate per valutare la bontà dell'adattamento. Tuttavia, una delle più comuni è l'R-quadro (noto anche come coefficiente di determinazione). L'R-quadro rappresenta la proporzione di varianza nella variabile dipendente spiegata dalle variabili indipendenti del modello. Il suo valore è compreso tra 0 e 1, con valori più alti che indicano un migliore adattamento. Nella regressione multipla, è essenziale considerare l'R-quadro corretto, che tiene conto del numero di variabili indipendenti nel modello. Il valore dell'R-quadro può aumentare con l'aggiunta di più variabili, anche se le variabili aggiuntive non contribuiscono in modo significativo al potere predittivo del modello. L'R-quadro corretto corregge questo problema penalizzando il valore dell'R-quadro per l'inclusione di variabili non necessarie. Ciò si traduce in una valutazione più accurata delle prestazioni del modello e aiuta a prevenire l'overfitting. Tuttavia, sia l'R-quadro che l'R-quadro corretto devono essere interpretati con cautela, poiché un valore elevato non garantisce un buon modello. Il modello potrebbe comunque essere soggetto a problematiche quali multicollinearità, distorsione dovuta a variabili omesse o altre violazioni delle ipotesi di regressione.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Presupposti chiave e limitazioni
L'analisi di regressione si basa su diversi presupposti chiave comuni a diversi tipi di regressione, comprese le estensioni di regressione lineare, logistica, polinomiale e multipla. Se queste ipotesi non vengono soddisfatte, l'accuratezza e la validità delle previsioni e delle conclusioni del modello potrebbero essere limitate. Pertanto, è fondamentale comprendere e valutare queste ipotesi quando si esegue l’analisi di regressione.
Forma funzionale appropriata:la relazione tra le variabili dipendenti e indipendenti deve seguire la forma funzionale del modello di regressione. Ciò significa una relazione lineare per la regressione lineare, mentre per la regressione polinomiale si assume una relazione polinomiale. L'analisi di diagrammi a dispersione o grafici dei residui può aiutare a identificare eventuali violazioni di questa ipotesi.
Indipendenza delle osservazioni:le osservazioni in un dataset devono essere indipendenti l'una dall'altra. Nell'autocorrelazione (quando osservazioni consecutive sono correlate), il modello di regressione può sottostimare la vera variabilità dei dati, portando a stime dei coefficienti e test di ipotesi inaffidabili.
Indipendenza degli errori:i residui (errori) devono essere indipendenti, ovvero l'errore relativo a un'osservazione non deve influenzare l'errore relativo a un'altra. Se gli errori sono correlati, gli errori standard dei coefficienti potrebbero essere sottostimati, portando a inferenze e intervalli di confidenza errati.
Omoschedasticità (per la regressione lineare e polinomiale):la varianza residua dovrebbe essere costante per tutti i livelli delle variabili indipendenti. Se la varianza cambia (un fenomeno chiamato eteroschedasticità), gli errori standard dei coefficienti potrebbero essere distorti, influenzando la verifica delle ipotesi e gli intervalli di confidenza.
Normalità dei residui (per regressione lineare e polinomiale):i residui (ovverole differenze tra i valori osservati e quelli previsti) dovrebbero seguire una distribuzione normale. Le violazioni della normalità possono influenzare la verifica delle ipotesi e la validità degli intervalli di confidenza.
Assenza di multicollinearità:le variabili indipendenti non devono essere fortemente correlate tra loro. La multicollinearità può causare stime dei coefficienti instabili e rendere difficile interpretare il contributo individuale di ciascuna variabile.
Funzione di collegamento specificata correttamente (per la regressione logistica):nella regressione logistica, la funzione di collegamento deve essere definita correttamente per trasformare i valori previsti in probabilità. L'utilizzo di una funzione di collegamento errata può portare a stime dei coefficienti distorte e previsioni imprecise.
Interpretazione dei risultati dell'analisi di regressione
Comprendere e interpretare i risultati dell'analisi di regressione è fondamentale per prendere decisioni migliori e trarre conclusioni significative. Ecco alcuni aspetti chiave da considerare quando si interpretano i risultati di qualsiasi modello di regressione, inclusa la regressione lineare, logistica, polinomiale e multipla:
Stime dei coefficienti:I coefficienti rappresentano l'effetto di ciascuna variabile indipendente sulla variabile dipendente, mantenendo costanti tutte le altre variabili. Nella regressione lineare e polinomiale, i coefficienti indicano la variazione della variabile dipendente per un incremento unitario della variabile indipendente. Nella regressione logistica, i coefficienti rappresentano la variazione del logaritmo delle probabilità dell'esito per un incremento unitario della variabile indipendente.
Significato dei coefficienti:I test di ipotesi, come i test t o i test z, vengono eseguiti per determinare la significatività statistica dei coefficienti. Un coefficiente statisticamente significativo suggerisce che la variabile indipendente ha un impatto rilevante sulla variabile dipendente. Un coefficiente non significativo implica che la variabile indipendente potrebbe non contribuire in modo significativo al modello.
Intervalli di confidenza:Gli intervalli di confidenza stimano l'intervallo entro il quale è probabile che ricada il coefficiente della popolazione. Intervalli più ristretti suggeriscono stime più precise, mentre intervalli più ampi indicano una maggiore incertezza.
Statistiche di adattamento del modello:le metriche di bontà dell'adattamento, come R-quadro, R-quadro corretto o il criterio di informazione di Akaike (AIC), possono aiutare a valutare le prestazioni complessive del modello. Queste metriche dovrebbero essere considerate insieme ad altre misure diagnostiche e grafici per valutare l'adeguatezza del modello.
Analisi dei residui:l'esame dei residui può rivelare modelli o tendenze che suggeriscono violazioni delle ipotesi di regressione o aree in cui il modello non si adatta bene ai dati. I grafici dei residui, i grafici di probabilità normale e i grafici di autocorrelazione possono essere utilizzati per diagnosticare potenziali problemi e guidare il miglioramento del modello.
Valori anomali e punti influenti:i valori anomali e i punti influenti possono avere un impatto significativo sul modello di regressione. Identificare e gestire queste osservazioni escludendole o utilizzando tecniche di regressione robuste può contribuire a migliorare le prestazioni del modello.
Validazione e generalizzazione: la convalida incrociata o la validazione hold-out possono essere utilizzate per valutare le prestazioni del modello su nuovi dati, contribuendo a misurarne la generalizzabilità e a prevenire l'overfitting.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Applicazioni pratiche dell'analisi di regressione
L'analisi di regressione è un potente strumento statistico con molte applicazioni pratiche in diversi settori. L'analisi di regressione può aiutare a informare il processo decisionale, ottimizzare i processi e prevedere i risultati futuri modellando la relazione tra le variabili dipendenti e indipendenti. Ecco alcuni esempi di come viene utilizzata l’analisi di regressione in vari settori:
Finanza ed economia:in finanza, l'analisi di regressione può essere utilizzata per modellare la relazione tra i prezzi delle azioni e gli indicatori economici, come i tassi di interesse o i tassi di disoccupazione. Questo può aiutare gli investitori a prendere decisioni migliori in merito all'allocazione del portafoglio e alla gestione del rischio. Inoltre, gli economisti possono utilizzare la regressione per studiare l'impatto delle politiche monetarie e fiscali sulla crescita economica e sull'inflazione.
Marketing e vendite:i modelli di regressione possono essere utilizzati per analizzare l'efficacia delle campagne di marketing, comprendere il comportamento dei consumatori e prevedere le vendite. Ad esempio, le aziende possono utilizzare la regressione per determinare l'impatto della spesa pubblicitaria sulle vendite, consentendo loro di ottimizzare il budget di marketing per massimizzare il ritorno sull'investimento.
Assistenza sanitaria:l'analisi di regressione esplora la relazione tra le caratteristiche del paziente e gli esiti di salute nel settore sanitario. Questo può aiutare a identificare i fattori di rischio di malattia, a orientare le decisioni terapeutiche e a ottimizzare l'assistenza al paziente. Ad esempio, la regressione logistica può prevedere la probabilità che un paziente sviluppi una particolare patologia in base a variabili demografiche e cliniche.
Produzione e controllo qualità:l'analisi di regressione può ottimizzare i processi produttivi, migliorare la qualità del prodotto e ridurre i costi di produzione. Modellando la relazione tra le variabili di processo e le caratteristiche del prodotto, le aziende possono individuare le condizioni ottimali per raggiungere le specifiche di prodotto desiderate, minimizzando al contempo gli sprechi e il consumo di risorse.
Risorse umane:nella gestione delle risorse umane, l'analisi di regressione può essere utilizzata per comprendere i fattori che influenzano le prestazioni, la fidelizzazione e la soddisfazione lavorativa dei dipendenti. Questo può aiutare le organizzazioni a sviluppare strategie mirate di reclutamento, formazione e coinvolgimento dei dipendenti, migliorando in definitiva la produttività e riducendo il turnover.
Analisi sportiva:i modelli di regressione sono sempre più utilizzati nell'analisi sportiva per valutare le prestazioni dei giocatori, supportare le decisioni degli allenatori e ottimizzare le strategie di squadra. Ad esempio, l'analisi di regressione multipla può quantificare il contributo delle statistiche individuali dei giocatori al successo della squadra, aiutando allenatori e dirigenti a prendere decisioni più consapevoli sulla composizione della rosa.
Scienza ambientale: nella ricerca ecologica, l'analisi di regressione può essere utilizzata per modellare la relazione tra fattori ambientali, come la temperatura o le precipitazioni, e risultati ecologici, come la distribuzione delle specie o la produttività degli ecosistemi. Ciò può fornire informazioni utili per le attività di conservazione, la gestione delle risorse naturali e lo sviluppo di politiche.
Insidie e idee sbagliate comuni nell'analisi di regressione
Sebbene l’analisi di regressione sia uno strumento statistico potente e ampiamente utilizzato, presenta sfide e potenziali insidie. Essere consapevoli di questi malintesi e problemi comuni può aiutare i professionisti a evitare errori e migliorare la qualità della loro analisi:
Correlazione vs. causalità:un errore comune nell'analisi di regressione è credere che la correlazione implichi la causalità. Sebbene la regressione possa identificare le relazioni tra le variabili, non dimostra necessariamente un nesso causale. Stabilire la causalità richiede una comprensione più approfondita dei meccanismi sottostanti e spesso implica l'utilizzo di disegni sperimentali o analisi aggiuntive.
Overfitting:la costruzione di un modello troppo complesso o che include troppe variabili indipendenti può portare all'overfitting, ovvero alla cattura del rumore presente nei dati anziché delle relazioni sottostanti. I modelli sovradattati hanno prestazioni scadenti su nuovi dati e possono portare a conclusioni fuorvianti. Per prevenire l'overfitting, è consigliabile utilizzare la convalida incrociata, la regolarizzazione o la selezione del modello basata su criteri informativi come AIC o BIC.
Multicollinearità:Quando le variabili indipendenti sono fortemente correlate, diventa difficile interpretare il contributo individuale di ciascuna variabile al modello. La multicollinearità può portare a stime instabili ed errori standard gonfiati. Rilevare la multicollinearità tramite i fattori di inflazione della varianza (VIF) o le matrici di correlazione e affrontarla attraverso tecniche come la selezione delle variabili o la riduzione della dimensionalità può contribuire a migliorare l'interpretazione e le prestazioni del modello.
Distorsione da variabili omesse:escludere variabili importanti dal modello di regressione può portare a stime dei coefficienti distorte e a conclusioni fuorvianti. Per evitare la distorsione da variabili omesse, assicurarsi che tutte le variabili rilevanti siano incluse nell'analisi. Valutare l'utilizzo della regressione stepwise o di tecniche di selezione del modello per identificare i predittori più importanti.
Violazione delle ipotesi:Ignorare o non verificare le ipotesi alla base dell'analisi di regressione può portare a risultati inaffidabili. È fondamentale valutare la validità delle ipotesi, come la linearità, l'indipendenza degli errori e l'omoschedasticità, e, se necessario, impiegare tecniche alternative o trasformazioni.
Estrapolazione:L'utilizzo di modelli di regressione per effettuare previsioni al di fuori dell'intervallo dei dati osservati può essere rischioso, poiché le relazioni tra le variabili potrebbero non essere valide nelle regioni non osservate. Si raccomanda cautela nell'estrapolare le previsioni e di considerare i limiti del modello e la possibilità che fattori imprevisti possano influenzare il risultato.
Interpretazione errata dei coefficienti: interpretare i coefficienti di regressione senza considerare la scala delle variabili o la funzione di collegamento (nel caso della regressione logistica) può portare a confusione e conclusioni errate. Assicurarsi che l'interpretazione dei coefficienti sia appropriata al contesto e tenga conto delle unità di misura, della direzione dell'effetto e dell'entità della relazione.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
L'analisi di regressione è uno strumento statistico potente e versatile che consente ai professionisti di modellare le relazioni tra variabili, fare previsioni e informare il processo decisionale in vari settori. Comprendendo i concetti fondamentali, come variabili dipendenti e indipendenti, coefficienti e bontà di adattamento, gli analisti possono selezionare il tipo appropriato di modello di regressione per i propri dati, inclusa la regressione lineare, logistica, polinomiale e multipla.
Tuttavia, è fondamentale essere consapevoli dei presupposti e dei limiti dell'analisi di regressione e interpretare attentamente i risultati per evitare trappole e malintesi comuni. Considerando le ipotesi, affrontando questioni come la multicollinearità e il sovradattamento e utilizzando tecniche come la convalida incrociata e la regolarizzazione, i professionisti possono costruire modelli più accurati e generalizzabili che forniscono informazioni preziose e guidano il processo decisionale basato sui dati.
In sintesi, l’analisi di regressione è uno strumento inestimabile per comprendere relazioni complesse e risolvere problemi del mondo reale, purché i professionisti siano consapevoli delle sue potenziali sfide e limitazioni e si impegnino a utilizzare il metodo in modo responsabile ed efficace.
Articoli consigliati
Pronti ad ampliare le vostre conoscenze? Consultate il nostro blog per altri articoli pertinenti e approfondite la vostra comprensione di questi test statistici fondamentali. Cogliete l'opportunità di migliorare le vostre competenze analisi dei dati e di prendere decisioni più consapevoli. Leggete ora!
- Come riportare i risultati della regressione lineare multipla in stile APA
- Come riportare i risultati della regressione lineare semplice in stile APA
- Presupposti nella regressione lineare: una guida completa
- Regressione logistica utilizzando R: la guida definitiva
- Quali sono le ipotesi di regressione logistica?
- Quali sono i 3 tipi di regressione logistica?
- Come creare linee di regressione in Excel
- Padroneggiare la regressione logistica (Storia)
Domande frequenti: cos'è l'analisi di regressione
L'analisi di regressione è un approccio statistico per modellare le relazioni tra variabili dipendenti e indipendenti per la previsione e il processo decisionale.
I tipi principali sono la regressione lineare, logistica, polinomiale e multipla, ciascuno adatto a diversi tipi di dati e obiettivi.
La correlazione misura la forza e la direzione di una relazione tra variabili. Allo stesso tempo, la causalità implica che una variabile influenzi direttamente l’altra.
Le ipotesi includono linearità, normalità, indipendenza dagli errori e omoschedasticità, che devono essere convalidate per ottenere risultati affidabili.
Quando le variabili indipendenti sono altamente correlate, si verifica la multicollinearità, rendendo difficile l’interpretazione dei contributi individuali. Può essere affrontato utilizzando tecniche di selezione variabile o di riduzione della dimensionalità.
L’overfitting si verifica quando un modello cattura il rumore piuttosto che le relazioni sottostanti, con conseguente scarsa generalizzabilità. Può essere prevenuto utilizzando la convalida incrociata, la regolarizzazione o la selezione del modello.
I coefficienti rappresentano l'effetto delle variabili indipendenti sulla variabile dipendente mantenendo costanti le altre variabili. L'interpretazione dipende dal tipo di regressione e dalle scale variabili.
L'analisi dei residui esamina i residui (differenze tra i valori osservati e quelli previsti) per identificare modelli, tendenze o violazioni delle ipotesi di regressione, guidando il miglioramento del modello.
L'analisi di regressione è ampiamente utilizzata in finanza, marketing, sanità, produzione, risorse umane, analisi sportiva e scienze ambientali.
Le insidie comuni includono la correlazione confusa con la causalità, l’overfitting, la multicollinearità, la distorsione da variabili omesse, l’estrapolazione e l’errata interpretazione dei coefficienti.