Presupposti nella regressione lineare: una guida completa
Apprenderai i fondamenti delle ipotesi alla base della regressione lineare e come convalidarle utilizzando esempi concreti per analisi dei dati.
Punti Salienti
- La regressione lineare è una tecnica di modellazione predittiva ampiamente utilizzata per comprendere le relazioni tra le variabili.
- La normalità dei residui aiuta a garantire previsioni imparziali e intervalli di confidenza affidabili nella regressione lineare.
- L'omoschedasticità garantisce che le previsioni del modello abbiano una precisione costante su diversi valori.
- Identificare e gestire la multicollinearità migliora la stabilità e l'interpretabilità del modello di regressione.
- Le tecniche di preelaborazione e trasformazione dei dati, come il ridimensionamento e la normalizzazione, possono mitigare potenziali problemi nella regressione lineare.
La regressione lineare è una tecnica per modellare e prevedere la relazione tra una variabile target e una o più variabili di input.
Ci aiuta a capire come una modifica nelle variabili di input influisce sulla variabile di destinazione.
La regressione lineare presuppone che una linea retta possa rappresentare questa relazione.
Ad esempio, supponiamo che tu voglia stimare il costo di un immobile considerando la sua dimensione (misurata in metri quadrati) e l'età (in anni).
In questo caso, il prezzo della casa è la variabile target, mentre la dimensione e l’età sono le variabili di input.
Utilizzando la regressione lineare, puoi stimare l'effetto delle dimensioni e dell'età sul prezzo della casa.
Ipotesi nella regressione lineare
Affinché il modello sia affidabile e valido, è necessario soddisfare sei ipotesi principali nella regressione lineare. Queste ipotesi sono:
1. Linearità
Questa ipotesi afferma che esiste una relazione lineare tra le variabili dipendenti e indipendenti. In altre parole, la variazione della variabile dipendente dovrebbe essere proporzionale alla variazione delle variabili indipendenti. La linearità può essere valutata utilizzando grafici a dispersione o esaminando i residui.
2. Normalità degli errori
I residui dovrebbero seguire una distribuzione normale con media pari a zero. Questa ipotesi è essenziale per una corretta verifica delle ipotesi e per la costruzione di intervalli di confidenza. La normalità degli errori può essere valutata utilizzando metodi visivi, come un istogramma o un grafico QQ, o attraverso test statistici, come il test di Shapiro-Wilk o il test di Kolmogorov-Smirnov.
3. Omoschedasticità
Questa ipotesi afferma che la varianza dei residui dovrebbe essere costante su tutti i livelli delle variabili indipendenti. In altre parole, lo spread dei residui dovrebbe essere simile per tutti i valori delle variabili indipendenti. L'eteroschedasticità, violando questo presupposto, può essere identificata utilizzando grafici a dispersione dei residui o test formali come il test di Breusch-Pagan.
4. Indipendenza dagli errori
Questo presupposto afferma che le osservazioni del set di dati dovrebbero essere indipendenti l'una dall'altra. Le osservazioni possono dipendere l'una dall'altra quando si lavora con serie temporali o dati spaziali a causa della loro vicinanza temporale o spaziale. La violazione di questo presupposto può portare a stime distorte e previsioni inaffidabili. In questi casi possono essere più appropriati modelli specializzati come serie temporali o modelli spaziali.
5. Assenza di multicollinearità (regressione lineare multipla)
La multicollinearità si verifica quando due o più variabili indipendenti nel modello di regressione lineare sono fortemente correlate, rendendo difficile stabilire l'effetto preciso di ciascuna variabile sulla variabile dipendente. La multicollinearità può portare a stime instabili, errori standard gonfiati e difficoltà nell'interpretazione dei coefficienti. È possibile utilizzare il fattore di inflazione della varianza (VIF) o la matrice di correlazione per rilevare la multicollinearità. In presenza di multicollinearità, si può valutare la possibilità di eliminare una delle variabili correlate, di combinare le variabili correlate o di utilizzare tecniche come l'analisi delle componenti principali (PCA) o la regressione ridge.
6. Indipendenza delle osservazioni
Questo presupposto afferma che le osservazioni del set di dati dovrebbero essere indipendenti l'una dall'altra. Le osservazioni possono dipendere l'una dall'altra quando si lavora con serie temporali o dati spaziali a causa della loro vicinanza temporale o spaziale. La violazione di questo presupposto può portare a stime distorte e previsioni inaffidabili. In questi casi possono essere più appropriati modelli specializzati come serie temporali o modelli spaziali.
Garantendo il rispetto di questi presupposti, è possibile aumentare l'accuratezza, l'affidabilità e l'interpretabilità dei modelli di regressione lineare. Se qualche presupposto viene violato, potrebbe essere necessario applicare trasformazioni di dati, utilizzare tecniche di modellazione alternative o prendere in considerazione altri approcci per affrontare i problemi.
❓ Confuso dall'analisi dei dati? La nostra guida completa lo renderà cristallino
| Ipotesi | Descrizione |
|---|---|
| Linearità | Relazione lineare tra variabili dipendenti e indipendenti, verificata utilizzando grafici a dispersione |
| Normalità | Distribuzione normale dei residui, valutata utilizzando il test di Shapiro-Wilk |
| Omoscedasticità | Varianza costante in termini di errore, valutata utilizzando il test di Breusch-Pagan |
| Indipendenza dagli errori | Termini di errore indipendenti, verificati utilizzando il test di Durbin-Watson |
| Indipendenza delle osservazioni | Punti dati raccolti in modo indipendente senza autocorrelazione |
| Assenza di multicollinearità | Nessuna multicollinearità tra le variabili indipendenti, determinata utilizzando le misure VIF e Tolleranza |
Esempio pratico
Ecco una dimostrazione di un problema basato sul modello di regressione lineare con due variabili indipendenti e una variabile dipendente.
In questo esempio, modelleremo la relazione tra la metratura e l'età di una casa con il suo prezzo di vendita.
Il set di dati contiene la metratura, l'età e il prezzo di vendita di 40 case.
Utilizzeremo la regressione lineare multipla per stimare gli effetti della metratura e dell'età sul prezzo di vendita.
Ecco una tabella con i dati che puoi copiare e incollare:
| Casa | Metratura | Età | Prezzo |
|---|---|---|---|
| 1 | 1500 | 10 | 250000.50 |
| 2 | 2000 | 5 | 300000.75 |
| 3 | 1200 | 15 | 200500.25 |
| 4 | 2500 | 2 | 400100.80 |
| 5 | 1800 | 8 | 270500.55 |
| 6 | 1600 | 12 | 220800.60 |
| 7 | 2200 | 4 | 320200.10 |
| 8 | 2400 | 1 | 420300.90 |
| 9 | 1000 | 18 | 180100.15 |
| 10 | 2000 | 7 | 290700.40 |
| 11 | 1450 | 11 | 240900.65 |
| 12 | 2050 | 6 | 315600.20 |
| 13 | 1150 | 16 | 190800.75 |
| 14 | 2600 | 3 | 410500.50 |
| 15 | 1750 | 9 | 260200.55 |
| 16 | 1550 | 13 | 210700.85 |
| 17 | 2300 | 3 | 330400.45 |
| 18 | 2450 | 2 | 415200.90 |
| 19 | 1100 | 17 | 185300.65 |
| 20 | 1900 | 8 | 275900.80 |
| 21 | 1400 | 12 | 235800.55 |
| 22 | 2100 | 6 | 305300.40 |
| 23 | 1300 | 14 | 195400.25 |
| 24 | 2700 | 3 | 410200.75 |
| 25 | 1700 | 10 | 255600.20 |
| 26 | 1650 | 11 | 215400.60 |
| 27 | 2150 | 5 | 325500.50 |
| 28 | 1250 | 15 | 205700.85 |
| 29 | 2550 | 4 | 395900.90 |
| 30 | 1850 | 9 | 265100.65 |
| 31 | 1350 | 13 | 225900.40 |
| 32 | 1950 | 7 | 285800.15 |
| 33 | 1100 | 16 | 195900.80 |
| 34 | 2800 | 3 | 430700.55 |
| 35 | 1750 | 10 | 245500.20 |
| 36 | 1600 | 12 | 225300.10 |
| 37 | 2000 | 7 | 310700.50 |
| 37 | 2000 | 7 | 310700.50 |
| 38 | 1200 | 15 | 201200.90 |
| 39 | 2600 | 4 | 380800.65 |
| 40 | 1800 | 8 | 279500.25 |
1. Linearità
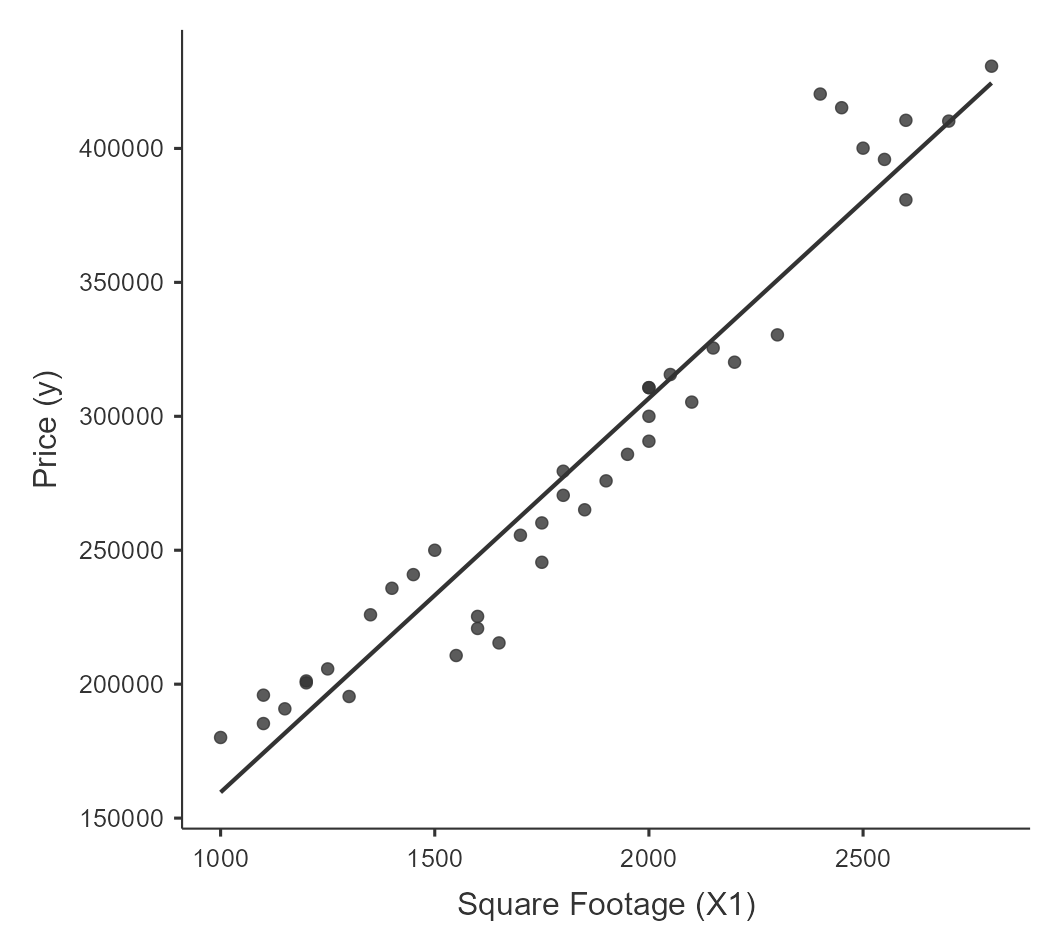
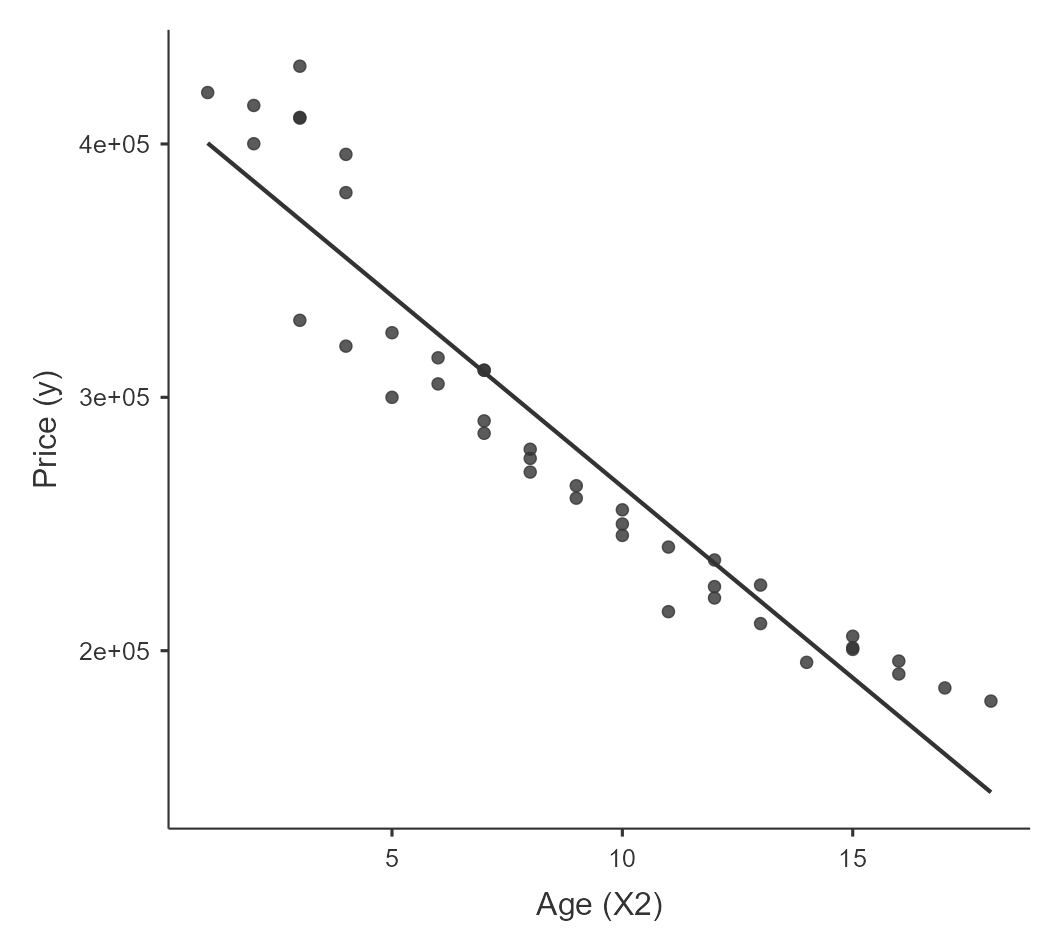
Valutare il presupposto della linearità esaminando visivamente il grafico a dispersione della variabile dipendente rispetto a ciascuna variabile indipendente per individuare uno schema lineare distinguibile.
2. Normalità degli errori
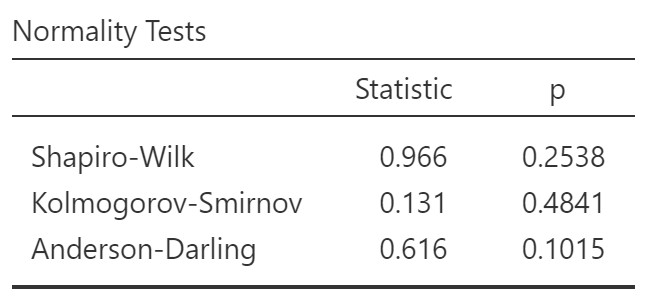
Valutare il presupposto di normalità eseguendo il test di Shapiro-Wilk, che valuta la distribuzione dei residui per deviazioni significative da una distribuzione normale.
Nel test di Shapiro-Wilk, un valore p elevato (tipicamente superiore a 0.05) indica che la distribuzione dei residui non differisce significativamente da una distribuzione normale.
3. Omoschedasticità
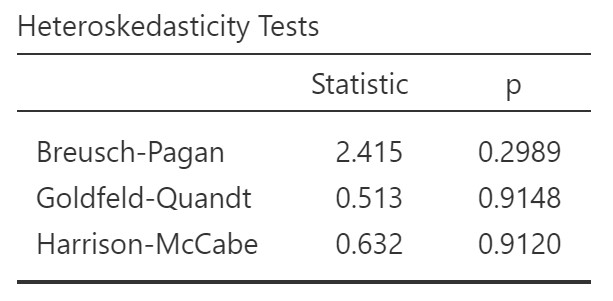
Valutare l'ipotesi di omoschedasticità eseguendo il test di Breusch-Pagan, che controlla la varianza non costante nei termini di errore.
Un valore p elevato (tipicamente superiore a 0.05) suggerisce che i dati presentano omoschedasticità, con varianza costante tra valori diversi.
4. Indipendenza dagli errori
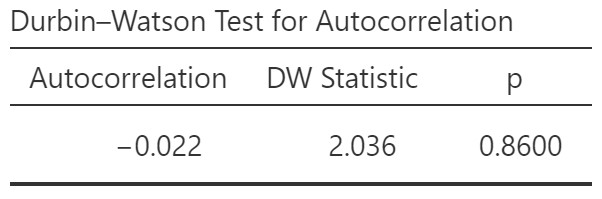
Una statistica di Durbin-Watson vicina a 2 suggerisce che gli errori sono indipendenti, con una minima autocorrelazione presente.
I valori inferiori o superiori a 2 indicano rispettivamente autocorrelazione positiva o negativa.
Il valore p indica che la statistica DW non è significativamente diversa da 2.
5. Assenza di multicollinearità
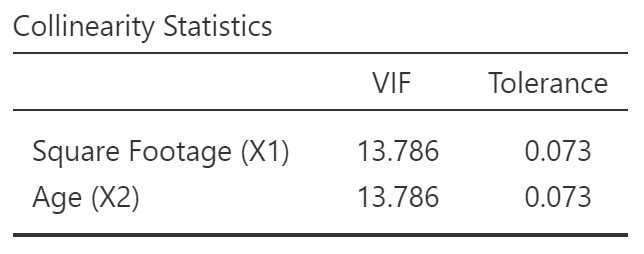
Valutare l'assenza di multicollinearità utilizzando il fattore di inflazione della varianza (VIF) e le misure di tolleranza. Valori VIF bassi (in genere inferiori a 10) e valori di tolleranza elevati (superiori a 0.1) indicano che la multicollinearità non costituisce un problema significativo nel modello di regressione.
I nostri dati indicano la presenza di multicollinearità tra le variabili età e metratura. Dovremo rimuoverne uno. La variabile da rimuovere può essere determinata in vari modi, ad esempio testando con semplici regressioni lineari per vedere quale si adatta meglio al modello o decidendo in base alla teoria sottostante.
6. Indipendenza delle osservazioni
Per evitare di violare il presupposto dell'indipendenza delle osservazioni, assicurati che i punti dati siano raccolti in modo indipendente e non presentino autocorrelazione, che può essere valutata utilizzando il test di Durbin-Watson.
Conclusione
È fondamentale esaminare e affrontare questi presupposti quando si costruisce un modello di regressione lineare per garantire validità, affidabilità e interpretabilità.
Comprendendo e verificando i sei presupposti – linearità, indipendenza degli errori, omoschedasticità, normalità degli errori, indipendenza delle osservazioni e assenza di multicollinearità – è possibile costruire modelli più accurati e affidabili, portando a un migliore processo decisionale e a una migliore comprensione delle relazioni tra le variabili nei dati.
Cogli l'occasione di accedere a estratti GRATUITI del nostro nuovo libro digitale e libera il tuo potenziale.
Approfondisci le tue conoscenze sui metodi avanzati analisi dei dati , impara a determinare la dimensione ottimale del campione e a comunicare i risultati in modo efficace, chiaro e conciso.
Clicca sul link per scoprire una vasta gamma di conoscenze: Statistica applicata: analisi dei dati.