Regressione lineare con Scikit-Learn: una guida completa
Imparerai l'arte e la scienza della modellazione predittiva con regressione lineare con scikit-learn.
Introduzione
La regressione lineare è una tecnica fondamentale nella scienza dei dati, poiché consente la previsione e l'interpretazione delle relazioni tra le variabili. Fondamentalmente, la regressione lineare modella la relazione tra una variabile dipendente e una o più variabili indipendenti, utilizzando un'equazione lineare per prevedere il risultato. Questa semplicità e la sua interpretabilità rendono la regressione lineare uno strumento vitale per analisti di dati e scienziati di varie discipline.
Questo articolo si propone di fornire una guida completa all'implementazioneregressione lineare con scikit-learn, una popolare libreria Python per l'apprendimento automatico. Scikit-learn offre un'ampia gamma di strumenti e algoritmi per analisi dei dati , il che lo rende una scelta ideale sia per i principianti che per i professionisti esperti del settore.
In questa guida approfondiremo le basi teoriche e le applicazioni pratiche della regressione lineare. Partendo dalle nozioni di base, esploreremo i presupposti e i calcoli matematici alla base dei modelli di regressione lineare. Da lì, passeremo a esempi pratici e pratici utilizzando scikit-learn per preparare dati, creare modelli di regressione lineare e interpretarne i risultati. Per illustrare questi concetti, possiamo utilizzare un set di dati creato in precedenza, dimostrando il processo di analisi di regressione lineare dalla preelaborazione dei dati alla valutazione del modello.
Unendo conoscenze teoriche e competenze pratiche, questa guida mira a fornire ai lettori una comprensione approfondita della regressione lineare nel contesto di scikit-learn, preparandoli ad applicare questi concetti alle sfide della scienza dei dati del mondo reale.
Punti Salienti
- La regressione lineare con scikit-learn può prevedere i risultati con notevole precisione.
- L'API di Scikit-learn semplifica le analisi statistiche complesse in passaggi comprensibili.
- La preelaborazione dei dati in scikit-learn migliora l'affidabilità e l'integrità del modello.
- Le tecniche avanzate in scikit-learn affrontano l'overfitting, migliorando la precisione del modello.
- Le applicazioni reali della regressione lineare con scikit-learn guidano decisioni di grande impatto.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprensione della regressione lineare
La regressione lineare è un metodo statistico fondamentale che rivela la relazione sottostante tra due o più variabili. Adattare un'equazione lineare ai dati osservati ci consente di comprendere e prevedere il comportamento di una variabile in base alla conoscenza di un'altra. Questa tecnica di modellazione predittiva non consiste solo nel trovare la linea che meglio si adatta ai dati, ma anche nello scoprire le verità nascoste nei dati, consentendo così un processo decisionale informato.
Fondamentalmente, la regressione lineare opera sulla base di una serie di presupposti che ne garantiscono l'applicazione pratica:
Linearità: La relazione tra le variabili indipendenti e dipendenti è lineare. Questo presupposto fondamentale implica che una variazione nella variabile indipendente comporterà una variazione proporzionale nella variabile dipendente.
Indipendenza: Le osservazioni sono indipendenti l'una dall'altra. Il risultato di ciascun dato non dipende dai risultati degli altri dati.
Omoscedasticità: la varianza dei termini di errore (residui) è costante per tutti i livelli delle variabili indipendenti. L'omoschedasticità garantisce che l'accuratezza predittiva del modello sia uniforme nell'intero intervallo della variabile indipendente.
Distribuzione normale degli errori: gli errori nella variabile dipendente sono distribuiti normalmente per qualsiasi valore fisso della variabile indipendente. Questa ipotesi ci permette di fare inferenze e di verificare le ipotesi sui coefficienti che rappresentano le variabili indipendenti.
Comprendere questi presupposti è fondamentale per applicare adeguatamente la regressione lineare, poiché le violazioni di questi presupposti possono portare a modelli imprecisi e risultati fuorvianti. Garantendo che i dati soddisfino questi prerequisiti, i professionisti possono sfruttare la regressione lineare al massimo delle sue potenzialità, rendendola un potente strumento per interpretare set di dati complessi.
L'utilizzo di scikit-learn per la regressione lineare implica la preparazione dei dati per soddisfare questi presupposti, seguita dall'adattamento, dalla valutazione e dall'interpretazione del modello. Attraverso questo processo, la regressione lineare con scikit-learn diventa non solo una formula matematica ma un ponte tra dati e decisione, teoria e applicazione, guidandoci verso previsioni più informate e accurate.
Introduzione a Scikit-Learn
Scikit-learn rappresenta un punto di riferimento nella comunità della scienza dei dati, una testimonianza dello spirito collaborativo e dell'etica open-source che guidano l'innovazione in questo campo. Come libreria, scikit-learn offre una suite completa di strumenti per il machine learning, dalla preelaborazione dei dati e la selezione del modello fino alla valutazione e all'ottimizzazione. I suoi principi di progettazione privilegiano la facilità d'uso, le prestazioni e la versatilità, rendendolo accessibile ai principianti ma al contempo sufficientemente robusto per gli esperti.
L'impegno della biblioteca verso una documentazione di alta qualità e il coinvolgimento della comunità esemplifica ulteriormente le migliori pratiche nello sviluppo di software per scopi scientifici ed educativi. Scikit-learn è una raccolta di algoritmi e una piattaforma per l'apprendimento, la sperimentazione e la scoperta. La sua architettura incoraggia le migliori pratiche nella modellazione dei dati, garantendo che gli utenti possano accedere a tecniche di apprendimento automatico all'avanguardia e comprenderne i principi.
Sfruttando scikit-learn per la regressione lineare e non solo, gli scienziati dei dati possono costruire modelli predittivi con sicurezza e chiarezza. L'implementazione della regressione lineare nella libreria, tramite la classe'LinearRegression', fornisce un'interfaccia potente ma intuitiva per adattare i modelli ai dati, analizzarne le prestazioni ed effettuare previsioni. Che si tratti di esplorare semplici relazioni lineari o di approfondire dataset multidimensionali più complessi, scikit-learn funge da guida affidabile attraverso le complessità del machine learning, incarnando la saggezza collettiva e l'impegno della comunità globale della scienza dei dati.
Preparazione dei dati
Prima di immergersi nella fase di modellazione con scikit-learn, è fondamentale preparare meticolosamente i dati per garantire l'integrità e la veridicità della propria analisi. La preelaborazione dei dati è un passaggio fondamentale nella pipeline del machine learning, che prevede la pulizia, la selezione delle funzionalità e la suddivisione dei dati in set di training e test.
Selezione delle caratteristiche: Inizia identificando le caratteristiche che hanno l'impatto più significativo sulla tua variabile dipendente. Non tutti i punti dati sono uguali; alcuni potrebbero avere poca o nessuna influenza sui risultati e potrebbero introdurre rumore se inclusi.
Pulizia dei dati: questa fase prevede la gestione dei valori mancanti, degli outlier e di eventuali dati errati che possono falsare i risultati del modello. Le opzioni per gestire i dati mancanti includono l'imputazione, il riempimento dei valori mancanti in base ad altri punti dati, l'omissione e la rimozione di punti dati o caratteristiche con valori mancanti.
Suddivisione dei dati: suddividere i dati in set di addestramento e di test è fondamentale. Questa pratica consente di addestrare il modello su un sottoinsieme dei dati e di testarne le prestazioni su un sottoinsieme separato e non visto in precedenza, fornendo una valutazione imparziale del modello.
Consideriamo il nostro set di dati creato in precedenza per un esempio pratico:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# Load the dataset
data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')

# Feature selection
X = data[['TV', 'Radio']]  # Independent variables
y = data['Sales']  # Dependent variable

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Model initialization and training
model = LinearRegression()
model.fit(X_train, y_train)

# Model evaluation
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f'Mean Squared Error: {mse}')
In questo esempio, abbiamo preparato i nostri dati selezionando le caratteristiche rilevanti ( budget pubblicitariper 'TV'e'Radio ') e la variabile target (‘ budget pubblicitari) e la variabile target ('Vendite'). Abbiamo quindi suddiviso i dati in set di addestramento e di test per garantire che il nostro modello possa essere valutato in modo equo. Seguendo questi passaggi, ci assicuriamo che il nostro modello sia robusto, accurato e rifletta la realtà dei dati sottostanti.
Implementazione della regressione lineare con Scikit-Learn
L'implementazione della regressione lineare con scikit-learn è semplice ed esemplifica la semplicità e la potenza della libreria. La chiarezza dell'API di scikit-learn rende accessibili e comprensibili anche le analisi complesse, consentendo ai data scientist di concentrarsi sugli approfondimenti piuttosto che sulle complessità degli algoritmi.
Scarica il set di dati!
Passaggio 1: Importa le librerie e carica i dati – Inizia importando le librerie necessarie e caricando il tuo set di dati. Useremo il set di dati che abbiamo preparato in precedenza:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')
Passaggio 2: Selezione delle caratteristiche e dell'obiettivo – Identifica le variabili indipendenti (caratteristiche) e la variabile dipendente (obiettivo). Nel nostro caso, "TV" e "Radio" sono le caratteristiche e "Vendite" è l'obiettivo:
X = data[['TV', 'Radio']]  # Features
y = data['Sales']  # Target
Passaggio 3: Suddividere i dati in set di addestramento e di test – Per valutare efficacemente le prestazioni del modello, suddividete i dati in set di addestramento e di test:
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Fase 4: Inizializzazione e addestramento del modello di regressione lineare – Scikit-learn semplifica enormemente l'inizializzazione e l'addestramento del modello:
model = LinearRegression()
model.fit(X_train, y_train)
Fase 5: Effettuare previsioni e valutare il modello – Una volta addestrato il modello, è possibile effettuare previsioni sul set di test e valutarne le prestazioni:
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"Mean Squared Error: {mse}")
print(f"R² Score: {r2}")
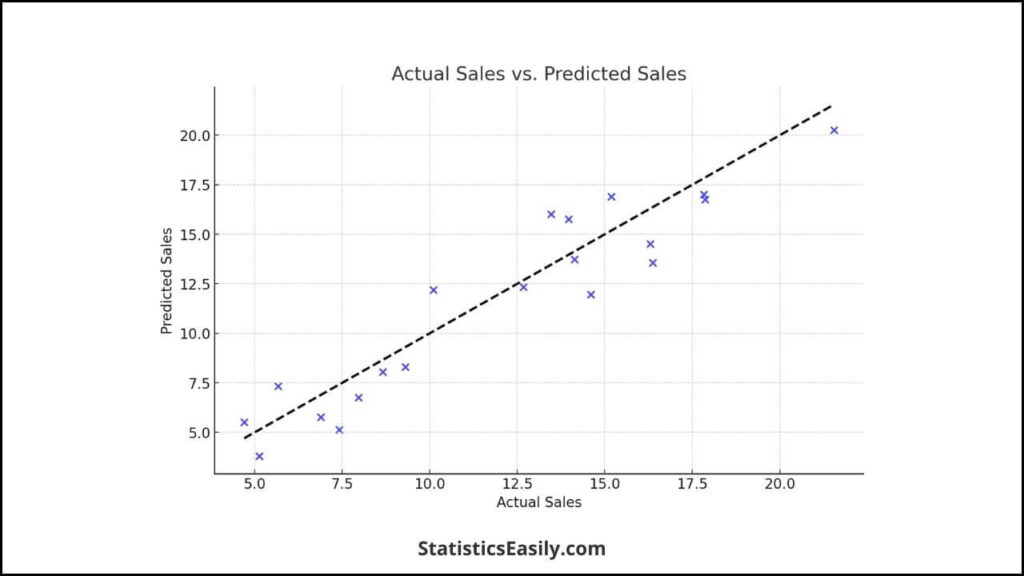
Visualizzazione delle prestazioni del modello – Le rappresentazioni visive possono fornire informazioni intuitive sulle prestazioni del modello. Ad esempio, rappresentando graficamente le vendite effettive rispetto a quelle previste:
import matplotlib.pyplot as plt

plt.scatter(y_test, y_pred)
plt.xlabel('Actual Sales')
plt.ylabel('Predicted Sales')
plt.title('Actual Sales vs. Predicted Sales')
plt.show()
Questo semplice grafico a dispersione fornisce una rapida valutazione visiva dell'accuratezza predittiva del modello, con i punti più vicini alla linea y = x che indicano prestazioni migliori.
Attraverso questi passaggi, scikit-learn demistifica il processo di implementazione della regressione lineare, rendendolo accessibile a principianti e professionisti esperti. Seguendo questa guida, puoi sfruttare la potenza della regressione lineare per scoprire informazioni significative dai tuoi dati, avvalendoti della chiarezza e della semplicità dell'API di scikit-learn.
Interpretazione dei risultati
L'interpretazione dell'output di un modello di regressione è un passaggio fondamentale nel processo analitico, poiché fornisce informazioni sulle relazioni tra le variabili e sul potere predittivo del modello. In questa sezione interpretiamo il modello di regressione lineare creato con scikit-learn, concentrandoci sul significato dei coefficienti, delle metriche del modello e delle considerazioni etiche nella presentazione dei risultati.
Interpretazione dei coefficienti
I coefficienti in un modello di regressione lineare rappresentano la variazione della variabile dipendente per una variazione di un'unità in una variabile indipendente, mantenendo costanti tutte le altre variabili. Nel nostro modello, i coefficienti per i budget pubblicitari di "TV" e "Radio" indicano i rispettivi impatti sulle "Vendite". Un coefficiente positivo suggerisce una relazione diretta: un aumento del budget pubblicitario porta ad un aumento delle vendite. Al contrario, un coefficiente negativo indica una relazione inversa.
Metriche del modello
Due parametri chiave per valutare le prestazioni di un modello di regressione lineare sono il valore dell'errore quadratico medio (MSE) e il valore R quadrato (R²).
L'MSEmisura la media dei quadrati degli errori, ovvero la differenza quadratica media tra i valori stimati e il valore effettivo. Un MSE inferiore indica un modello che si adatta meglio ai dati.
R²rappresenta la proporzione della varianza nella variabile dipendente che è prevedibile a partire dalle variabili indipendenti, e varia da 0 a 1. Un valore di R² più vicino a 1 indica un modello che spiega una porzione significativa della varianza nella variabile dipendente.
Interpretazione onesta e considerazioni etiche
Quando si interpretano e si presentano i risultati di un'analisi di regressione, l'onestà e le considerazioni etiche sono fondamentali. È essenziale riconoscere i limiti del modello, comprese eventuali ipotesi che potrebbero non essere del tutto vere o variabili che non possono essere prese in considerazione. Sopravvalutare l'accuratezza o il potere predittivo del modello può portare a decisioni e interpretazioni errate.
La trasparenza sulle fonti dei dati, sulle fasi di preelaborazione e sulla logica alla base della scelta di variabili specifiche favorisce la fiducia e la credibilità nei risultati. Inoltre, ogni data scientist è eticamente responsabile di considerare il potenziale impatto di questi risultati sulle parti interessate e di garantire che le interpretazioni non siano fuorvianti o dannose.
Interpretare i risultati di un modello di regressione lineare implica un attento esame dei coefficienti e delle metriche del modello, insieme all’impegno per l’onestà e l’integrità etica nella presentazione dei risultati. Questo approccio garantisce l'affidabilità dell'analisi e sostiene i principi di verità nella scienza dei dati.
Regressione lineare con argomenti avanzati di Scikit-Learn
Emergono diverse tecniche avanzate con l'obiettivo di perfezionare i modelli di regressione lineare e di migliorarne l'accuratezza predittiva. Questi metodi affrontano sfide comuni come l'overfitting e approfondiscono la nostra comprensione dell'analisi di regressione lineare, dimostrandone la versatilità e la profondità.
Regolarizzazione: una chiave per mitigare l’overfitting
Tecniche di regolarizzazione come Ridge (regolarizzazione L2) e Lasso (regolarizzazione L1) impediscono l'overfitting. Questo errore comune si verifica quando il modello funziona bene con i dati di training ma male con i dati invisibili. Introducendo un termine di penalità nella funzione di perdita, i metodi di regolarizzazione vincolano l’entità dei coefficienti, scoraggiando così il modello dal diventare eccessivamente complesso.
La regressione Ridgeaggiunge una penalità pari al quadrato dell'entità dei coefficienti, riducendoli di fatto e diminuendo la complessità del modello.
La regressione Lasso, d'altro canto, può ridurre alcuni coefficienti a zero, eseguire la selezione delle caratteristiche e offrire un modello più interpretabile.
Implementarli in scikit-learn è semplice:
from sklearn.linear_model import Ridge, Lasso

# Ridge regression
ridge_model = Ridge(alpha=1.0)
ridge_model.fit(X_train, y_train)

# Lasso regression
lasso_model = Lasso(alpha=0.1)
lasso_model.fit(X_train, y_train)
The 'alpha'controlla l'intensità della regolarizzazione: valori più elevati comportano vincoli più significativi sui coefficienti.
Tecniche di valutazione e validazione dei modelli
Valutare e validare le prestazioni dei modelli di regressione lineare è fondamentale per garantirne l'affidabilità e l'accuratezza. La convalida incrociata, una tecnica robusta, prevede la divisione del set di dati in diversi sottoinsiemi e l'addestramento del modello su alcuni sottoinsiemi mentre lo si testa su quelli rimanenti. Questo approccio fornisce una valutazione più completa delle prestazioni del modello nei diversi segmenti di dati.
from sklearn.model_selection import cross_val_score

# Cross-validation with 5 folds
scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error')
The 'cross_val_score'di scikit-learn facilita la convalida incrociata, con il parametro'cv'che specifica il numero di fold. La scelta della metrica di punteggio, come l'errore quadratico medio negativo, dipende dagli obiettivi specifici dell'analisi.
Ricerca della verità e dell'accuratezza nella performance del modello
L'adesione ai principi di verità e accuratezza è fondamentale quando si porta avanti l'analisi di regressione lineare attraverso tecniche come la regolarizzazione e la convalida incrociata. La regolarizzazione mira alla veridicità del modello impedendogli di adattarsi al rumore. Allo stesso tempo, la convalida incrociata garantisce l'accuratezza dei parametri prestazionali del modello fornendo una valutazione olistica.
La presentazione etica dei risultati dei dati, riconoscendo i limiti e i potenziali errori del modello, rafforza l’integrità dell’analisi. Queste tecniche avanzate e considerazioni etiche garantiscono che l'analisi di regressione lineare continui a essere uno strumento potente nell'arsenale dei data scientist, in grado di scoprire informazioni con precisione e affidabilità.
Regressione lineare con Scikit-Learn in applicazioni del mondo reale
L’applicazione della regressione lineare nell’ambito dello scikit-learn si estende ben oltre i costrutti teorici, radicandosi profondamente nel tessuto della risoluzione dei problemi del mondo reale. Questa sezione illustra l'utilità pratica della regressione lineare in scikit-learn, attraverso vivide illustrazioni della sua applicazione in diversi ambiti, sottolineando l'impatto trasformativo della scienza dei dati sulla società.
Previsione dei prezzi degli immobili:una delle applicazioni per eccellenza della regressione lineare si trova nel settore immobiliare, dove viene utilizzata per prevedere i prezzi degli immobili in base a diverse caratteristiche come la metratura, la posizione, il numero di camere da letto e l'età dell'immobile. Addestrando un modello di regressione lineare su dati storici, gli analisti immobiliari possono stimare il valore di mercato degli immobili, guidando acquirenti e venditori a prendere decisioni informate.
Previsione di vendite e ricavi:le aziende di tutti i settori utilizzano la regressione lineare per prevedere vendite e ricavi, tenendo conto della spesa pubblicitaria, delle tendenze stagionali e degli indicatori economici. Ad esempio, un'azienda di vendita al dettaglio potrebbe utilizzare la regressione lineare per comprendere l'impatto di una campagna pubblicitaria sulle vendite, consentendo un'allocazione strategica dei budget di marketing per massimizzare il ritorno sull'investimento.
Assistenza sanitaria: Previsione della progressione della malattia:In ambito sanitario, i modelli di regressione lineare sono fondamentali per prevedere la progressione della malattia sulla base di dati del paziente quali età, peso, pressione sanguigna e livelli di colesterolo. Questa applicazione non solo contribuisce alla diagnosi precoce e alla personalizzazione dei piani di trattamento, ma anche a un'allocazione efficiente delle risorse sanitarie.
Analisi del consumo energetico:gli analisti del settore energetico utilizzano la regressione lineare per prevedere i modelli di consumo sulla base di dati storici, condizioni meteorologiche e attività economica. Tali previsioni sono fondamentali per le aziende di generazione e distribuzione di energia al fine di gestire efficacemente domanda e offerta, contribuendo a pratiche di gestione energetica sostenibili.
Caso di successo: Miglioramento della resa agricola:Un notevole caso di successo è l'applicazione della regressione lineare in agricoltura per prevedere la resa dei raccolti. Analizzando variabili come precipitazioni, temperatura, qualità del suolo e varietà delle colture, gli agronomi possono prevedere i raccolti, ottimizzando così le pratiche agricole per una maggiore produttività. Ciò contribuisce alla sicurezza alimentare e supporta l'agricoltura sostenibile, riducendo al minimo gli sprechi e il consumo di risorse.
Queste applicazioni del mondo reale sottolineano la versatilità e la praticità della regressione lineare con scikit-learn nell'affrontare sfide complesse in vari settori. Sfruttando la potenza dei dati, i modelli di regressione lineare illuminano percorsi verso decisioni consapevoli, guidando il progresso e favorendo un impatto positivo sulla società. Attraverso queste narrazioni, assistiamo all’incarnazione dei principi di verità, bontà e bellezza nell’applicazione della scienza dei dati, riaffermando il ruolo profondo della regressione lineare nel plasmare un futuro migliore.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
Attraversando il panorama dellaregressione lineare con scikit-learn, abbiamo intrapreso un viaggio completo attraverso i fondamenti teorici e le implementazioni pratiche di una delle tecniche più basilari della scienza dei dati. La regressione lineare è un faro per la previsione e l'interpretazione della complessa interazione tra variabili dipendenti e indipendenti, la cui eleganza risiede nella semplicità e nell'interpretabilità.
Questa guida ha cercato di fornire a te, lettore, una solida conoscenza della regressione lineare all'interno del framework scikit-learn, unendo le basi teoriche con applicazioni pratiche. Dai passi iniziali in cui si affrontano i presupposti fondamentali che sono alla base dei modelli di regressione lineare fino agli esercizi pratici di preparazione dei dati, costruzione del modello e interpretazione dei risultati, abbiamo percorso un percorso che unisce teoria e pratica, intuizione e applicazione.
Scikit-learn, con il suo ricco repository di strumenti e algoritmi, si è rivelato un alleato prezioso in questo viaggio. La sua API intuitiva e l'ampia documentazione hanno demistificato complesse analisi statistiche, rendendo il potere della regressione lineare accessibile a tutti coloro che cercano di svelare i modelli nascosti nei loro dati.
Le applicazioni del mondo reale qui evidenziate – dalla previsione dei prezzi delle case alla previsione delle vendite, al miglioramento dell’assistenza sanitaria e all’ottimizzazione dei rendimenti agricoli – sottolineano l’impatto pervasivo della regressione lineare nel guidare decisioni informate in vari settori. Queste narrazioni mostrano l’utilità della regressione lineare e celebrano il potere di trasformazione della scienza dei dati nella società.
Mentre concludiamo questa guida completa, lascia che il viaggio non finisca qui. Il campo della regressione lineare, in particolare all’interno dell’ecosistema scikit-learn, è vasto e maturo con potenziale di esplorazione. Ti incoraggio ad approfondire, sperimentare con i tuoi set di dati e scoprire come la regressione lineare può illuminare l'ignoto, guidare decisioni strategiche e contribuire al bene comune.
Articoli consigliati
Esplora ulteriori approfondimenti e migliora il tuo percorso nella scienza dei dati con i nostri altri articoli approfonditi su argomenti simili.
- Cos'è l'analisi di regressione? Una guida completa per principianti
- Come riportare i risultati della regressione lineare multipla in stile APA
- Come riportare i risultati della regressione lineare semplice in stile APA
- Presupposti nella regressione lineare: una guida completa
- Come calcolare i residui nell'analisi di regressione?
- Analisi di regressione lineare: tracciare linee in R
Domande frequenti (FAQ)
D1: Come si esegue la regressione lineare con Scikit?Utilizza la classe 'LinearRegression' di scikit-learn per modellare e prevedere in modo efficiente le relazioni tra variabili indipendenti e dipendenti.
D2: Cos'è un punteggio di regressione lineare?Il punteggio si riferisce al coefficiente di determinazione R² della previsione, che misura la proporzione di varianza nella variabile dipendente che è prevedibile dalla/e variabile/i indipendente/i.
D3: Come si importa una regressione lineare in Python?Utilizzare `from sklearn.linear_model import LinearRegression` per importare la classe `LinearRegression` dal modulo `linear_model` di scikit-learn.
D4: Cosa sono l'intercetta e il coefficiente di una regressione lineare in Python?L'intercetta è il valore della variabile dipendente quando tutte le variabili indipendenti sono zero. I coefficienti sono i valori che moltiplicano i valori delle variabili indipendenti, rappresentando la loro relazione con la variabile dipendente.
D5: Come si interpretano i coefficienti della regressione lineare in Scikit-Learn?I coefficienti indicano la variazione attesa nella variabile dipendente per una variazione di un'unità in ciascuna variabile indipendente, mantenendo costanti le altre variabili.
D6: Cos'è l'overfitting e come si può affrontare?L'overfitting si verifica quando un modello cattura il rumore invece del modello sottostante. Tecniche come la convalida incrociata e la regolarizzazione all'interno di scikit-learn attenuano questo problema.
D7: La regressione lineare può gestire variabili categoriche?Utilizzando tecniche come la codifica one-hot, le variabili categoriche possono essere efficacemente incorporate nei modelli di regressione lineare in scikit-learn.
D8: Come si convalida un modello di regressione lineare?La convalida prevede l'utilizzo di tecniche come la convalida incrociata e la valutazione di metriche di prestazione come R² e RMSE per garantire l'accuratezza e l'affidabilità del modello.
D9: Come si può migliorare l'accuratezza di un modello di regressione lineare?Il miglioramento dell'accuratezza può includere l'ingegneria delle caratteristiche, come la selezione di variabili rilevanti e l'applicazione di tecniche di regolarizzazione come Ridge o Lasso per ridurre l'overfitting e migliorare le prestazioni del modello.
D10: Quali sono alcune tipiche applicazioni pratiche della regressione lineare?La regressione lineare è ampiamente utilizzata nelle previsioni (come quelle di vendita e meteorologiche), nella valutazione del rischio in ambito finanziario e assicurativo e nella valutazione di tendenze e relazioni nella ricerca scientifica, dimostrando la sua versatilità in diversi settori.