Regressione logistica utilizzando R: la guida definitiva
Imparerai il ruolo chiave della regressione logistica utilizzando R nell'analisi predittiva e nel processo decisionale basato sui dati.
Introduzione
Nel dinamico campo della scienza dei dati,regressione logisticaè uno strumento fondamentale per i problemi di classificazione binaria, offrendo approfondimenti significativi sui dati attraverso la modellazione predittiva. Questa tecnica statistica, in particolare se utilizzata conR, uno strumento versatile rinomato per le sue capacità di analisi e modellazione statistica, consente ad analisti e ricercatori di scoprire modelli nascosti e prendere decisioni informate. La sinergia tra regressione logistica e R fornisce ai professionisti un solido framework per affrontare complesse sfide legate ai dati, ponendo le basi per l'innovazione basata sui dati e per intuizioni strategiche. Questa guida si propone di illustrare il percorso per padroneggiare la regressione logistica con R, assicurando ai lettori le conoscenze necessarie per sfruttare appieno il potenziale di questo potente approccio analitico.
Punti Salienti
- R semplifica i modelli di regressione logistica complessi per una migliore precisione predittiva.
- La regressione logistica in R aiuta a distinguere in modo efficiente i risultati binari.
- La preelaborazione dei dati in R migliora l'affidabilità del modello di regressione logistica.
- La sintassi di R facilita l'implementazione intuitiva dell'analisi di regressione logistica.
- Gli esempi del mondo reale illustrano il valore pratico della regressione logistica utilizzando R.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprensione della regressione logistica
La regressione logistica è un pilastro della scienza dei dati, in particolare quando si risolvono problemi di classificazione con risultati dicotomici, come spam o non spam, vittoria o sconfitta, salute o malattia. A differenza della regressione lineare, che prevede risultati con un intervallo continuo,regressione logisticafornisce un punteggio di probabilità che un dato insieme di caratteristiche o input rientri in una categoria specifica. Questo la rende preziosa in campi come la medicina per prevedere la probabilità di una malattia, la finanza per la probabilità di insolvenza e il marketing per prevedere il comportamento dei clienti.
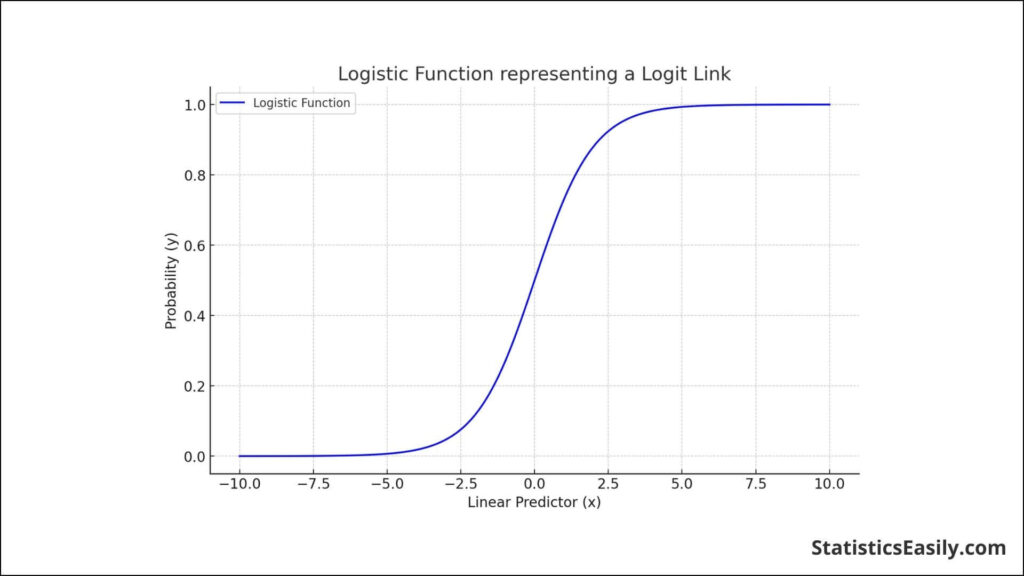
Il fondamento matematico della regressione logistica risiede nella funzione logistica, spesso chiamata funzione sigmoide. Questa curva a forma di S può mappare qualsiasi numero con valori reali in un valore compreso tra 0 e 1, rendendola perfetta per modellare i punteggi di probabilità nelle attività di classificazione binaria. L'equazione della regressione logistica contrasta con quella della regressione lineare principalmente per l'uso della funzione logistica per modellare la variabile dipendente. Il modello di regressione logistica stima quindi la probabilità che un dato punto di input appartenga ad una determinata classe, che può essere espressa matematicamente come:
P(Y=1∣X)=1/1+e−(β0+β1X)
dove P(Y=1∣X) è la probabilità che la variabile dipendente Y sia uguale a uno date le variabili indipendenti X, e è la base del logaritmo naturale, β0 è il termine di intercetta e β1 rappresenta il/i coefficiente/i della/e variabile/i indipendente/i che influenzano la variabile dipendente.
In R, la regressione logistica può essere implementata utilizzando funzioni come 'glm()' (Generalized Linear Models), impostando la famiglia su binomial per specificare che si tratta di una regressione logistica binomiale. La semplicità di questa implementazione, combinata con la vasta gamma di strumenti di R per la manipolazione e l'analisi dei dati, rende la regressione logistica in R un approccio potente per la modellazione predittiva. Grazie alle funzionalità di R, gli scienziati dei dati possono pre-elaborare i dati, costruire modelli di regressione logistica, valutarne le prestazioni e utilizzarli per le previsioni con relativa facilità, rafforzando lo status di R come strumento versatile nell'arsenale analisi dei dati e modellazione.
Iniziare con R
Intraprendere il proprio percorso con R, un linguaggio e un ambiente rinomati per il calcolo statistico e la grafica, inizia con la creazione delle basi necessarie. Per i principianti, il primo passo consiste nell'installare R, un'operazione semplice e accessibile dalComprehensive R Archive Network (CRAN). Insieme a R, si consiglia vivamente di installareRStudio, un potente IDE che migliora l'esperienza utente di R grazie alla sua interfaccia intuitiva e alle funzionalità aggiuntive.
Al momento dell'installazione, familiarizzare con la sintassi di R è fondamentale per l'analisi pratica dei dati. La sintassi di R è unica ma intuitiva e consente agli utenti di eseguire complesse manipolazioni e analisi dei dati con codice conciso. I concetti chiave includono:
- Variabili e tipi di dati:Comprendere come assegnare valori alle variabili e ai vari tipi di dati in R, come numerici, caratteri e logici.
- Vettori e frame di dati:Comprendere la creazione e la manipolazione di vettori e frame di dati, la spina dorsale dell'analisi dei dati in R.
- Funzioni e pacchetti:Impara a utilizzare le funzioni integrate e a installare e caricare pacchetti, estendendo le capacità di R ben oltre le sue funzionalità di base. Pacchetti come "glmnet" e "caret" sono preziosi per la regressione logistica.
- Strutture di controllo:Impara strutture di controllo come istruzioni e cicli if-else, che ti consentono di controllare il flusso di esecuzione nei tuoi script.
Un esempio semplice ma illustrativo della sintassi di R in azione è la creazione e la manipolazione di un frame di dati, che potrebbe assomigliare a questo:
# Create a data frame
my_data <- data.frame(
  Outcome = c("Success", "Fail", "Success", "Fail"),
  Age = c(22, 45, 33, 29),
  Score = c(85, 47, 76, 62)
)

# View the data frame
print(my_data)

# Calculate the mean Score
mean_score <- mean(my_data$Score)
print(paste("Average Score:", mean_score))
Questo frammento illustra l'assegnazione delle variabili, la creazione di frame di dati e l'utilizzo delle funzioni primarie. La potente suite di strumenti di R e l'approccio completo alla manipolazione e all'analisi dei dati lo rendono una competenza essenziale sia per i data scientist che per gli statistici.
Preparazione dei dati per la regressione logistica
Un passaggio fondamentale prima di applicare la regressione logistica in R èla pulizia e la preelaborazione dei dati. Questo processo garantisce che il set di dati sia formattato correttamente, privo di errori o informazioni irrilevanti e strutturato in modo da migliorare le prestazioni e l'accuratezza del modello di regressione logistica.
Pulizia dei daticomprende diverse attività fondamentali:
- Gestione dei valori mancanti:Usa funzioni come 'na.omit()' per rimuovere o 'impute()' dal pacchetto mice per riempire i valori mancanti con le stime.
- Rimozione dei valori anomali:I valori anomali possono distorcere i risultati. Tecniche come il metodo Interquartile Range (IQR) possono aiutare a identificare e rimuovere queste anomalie.
- Garantire la coerenza dei dati:Standardizza la formattazione dei dati, ad esempio formati di data e valori di categoria, per evitare incoerenze.
Preprocessing dei daticomprende:
- Selezione variabile:Identifica quali variabili sono più rilevanti per il risultato previsto. Ciò potrebbe comportare tecniche statistiche come l’analisi delle correlazioni o la competenza nel settore.
- Trasformazione dei dati:Converti le variabili categoriali in variabili fittizie o fattori con funzioni come 'factor()' o 'model.matrix()', poiché la regressione logistica richiede input numerici.
- Ridimensionamento delle funzionalità:Sebbene non sia sempre necessaria per la regressione logistica, la standardizzazione delle caratteristiche tramite funzioni di ridimensionamento può talvolta migliorare le prestazioni del modello.
Un esempio illustrativo di preparazione dei dati potrebbe comportare la trasformazione di una variabile categoriale in un formato adatto alla regressione logistica:
# Assuming 'Gender' is a categorical variable with levels 'Male' and 'Female'
my_data$Gender <- factor(my_data$Gender, levels = c("Male", "Female"))

# Transforming 'Gender' into a dummy variable
my_data <- model.matrix(~ Gender + Age + Score - 1, data = my_data)
Questo frammento mostra la conversione della variabile categoriale "Sesso" in una variabile fittizia, un passaggio standard nella preparazione dei dati per la regressione logistica. Ciò consente al modello di incorporare queste informazioni in modo efficace.
The importanza della selezione delle variabili appropriatenon può essere sottovalutata. Includere variabili che predicono fortemente il risultato può migliorare l'accuratezza del modello, mentre variabili irrilevanti potrebbero diluirne il potere predittivo. Tecniche come l'eliminazione a ritroso, la selezione in avanti o persino algoritmi di apprendimento automatico come Random Forest possono essere impiegati per identificare i predittori significativi.
In sintesi, un’attenta preparazione dei dati apre la strada a un robusto modello di regressione logistica. Approfondisce la comprensione del set di dati, portando a un'analisi dei dati più approfondita e di grande impatto.
Implementazione della regressione logistica utilizzando R
L'implementazione della regressione logistica in R implica un approccio chiaro e strutturato. Questa sezione ti guiderà attraverso i passaggi per eseguire la regressione logistica, inclusi snippet di codice per maggiore chiarezza. L'attenzione sarà focalizzata su come costruire il modello, interpretarne l'output e comprendere il significato dei coefficienti e dell'adattamento del modello.
Guida passo-passo
1. Caricamento del pacchetto necessario:per eseguire la regressione logistica, assicurarsi di avere il pacchetto 'stats', preinstallato in R. Questo pacchetto include la funzione 'glm()', essenziale per la regressione logistica.
# Ensure the stats package is loaded (it should be by default)
library(stats)
2. Costruzione del modello di regressione logistica:utilizzare la funzione 'glm()', specificando la famiglia binomiale per indicare la regressione logistica. Si supponga che 'my_data' sia il set di dati, 'Outcome' sia la variabile dipendente binaria e 'Predictor1', 'Predictor2' siano le variabili indipendenti.
# Building the logistic regression model as before
logistic_model <- glm(Outcome ~ Predictor1 + Predictor2, family = binomial, data = my_data)

# Performing a Likelihood Ratio Test
anova(logistic_model, test = "Chisq")
3. Riepilogo del modello:Per comprendere i coefficienti del modello e il loro significato, utilizzare la funzione 'summary()'.
# Summarizing the logistic regression model
summary(logistic_model)
Interpretazione dell'output
- Coefficienti:L'output di riepilogo fornisce coefficienti per ciascun predittore. Questi coefficienti rappresentano le probabilità di registro per la variabile di risultato. Un coefficiente positivo indica che all'aumentare della variabile predittrice, le probabilità logaritmiche che si verifichi il risultato aumentano, rendendo l'evento più probabile.
- Livelli di significatività:Osserva la colonna "Pr(>|z|)" nell'output di riepilogo. I valori qui rappresentano il valore p per ciascun coefficiente. In genere, un valore p inferiore a 0.05 indica che il predittore è significativamente associato alla variabile di risultato.
- Vestibilità del modello:La sintesi include anche misure di bontà di adattamento. La devianza nulla e residua indica quanto bene il modello si adatta ai dati. Una devianza residua inferiore rispetto alla devianza nulla suggerisce un buon adattamento. Inoltre, l'Akaike Information Criterion (AIC) misura la qualità del modello, dove un AIC inferiore indica un modello che si adatta meglio ai dati senza adattarsi eccessivamente.
Esempio di interpretazione riassuntiva
Considera lo snippet di output seguente da un riepilogo della regressione logistica:
Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -1.2345     0.2079  -5.939  3.00e-09 ***
Predictor1     0.4456     0.1102   4.045  5.25e-05 ***
Predictor2    -0.5678     0.1456  -3.900  9.68e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 234.83  on 170  degrees of freedom
Residual deviance: 144.57  on 168  degrees of freedom
AIC: 150.57
- L'"Intercetta" e il "Predictor1" e il "Predictor2" sono significativi (p <0.05).
- "Predictor1" ha un coefficiente positivo, suggerendo che l'aumento di "Predictor1" aumenta le probabilità logaritmiche del risultato.
- "Predictor2" ha un coefficiente negativo, indicando che un aumento di "Predictor2" diminuisce le probabilità logaritmiche del risultato.
- Il sostanziale calo della devianza e del valore AIC suggerisce un buon adattamento del modello.
Seguendo questi passaggi e comprendendo l'output del modello, è possibile implementare in modo efficace la regressione logistica in R, aprendo la strada all'analisi approfondita dei dati e alla modellazione predittiva.
Migliorare la regressione logistica utilizzando R
Il miglioramento dell'accuratezza e del potere predittivo di un modello di regressione logistica in R comporta diversi passaggi strategici, dalla selezione attenta delle funzionalità alle tecniche avanzate di valutazione del modello. Ecco alcuni suggerimenti e metodi per migliorare il modello di regressione logistica:
Selezione e trasformazione delle funzionalità
1. Importanza delle variabili:Utilizza tecniche come la regressione stepwise o algoritmi di apprendimento automatico (ad esempio, Random Forest) per identificare le caratteristiche più predittive per il tuo modello. Questo aiuta a semplificare il modello mantenendo solo i predittori significativi.
library(MASS)
stepwise_model <- stepAIC(logistic_model, direction = "both")
summary(stepwise_model)
2. Gestione della multicollinearità:un'elevata correlazione tra i predittori può distorcere la significatività delle variabili. Utilizzare il fattore di inflazione della varianza (VIF) per verificare la presenza di multicollinearità e valutare la possibilità di rimuovere o combinare le variabili altamente correlate.
library(car)
vif(logistic_model)
3. Trasformazione dei dati:le relazioni non lineari tra i predittori e il logaritmo delle probabilità possono essere catturate tramite trasformazioni come termini polinomiali o effetti di interazione.
logistic_model <- glm(Outcome ~ poly(Predictor1, 2) + Predictor2 + Predictor1:Predictor2, family = binomial, data = my_data)
Tecniche di valutazione del modello
1. Validazione incrociata:implementare la validazione incrociata k-fold per valutare le prestazioni predittive del modello su dati non visti, il che aiuta a mitigare l'overfitting.
library(caret)
control <- trainControl(method = "cv", number = 10)
cv_model <- train(Outcome ~ Predictor1 + Predictor2, data = my_data, method = "glm", family = "binomial", trControl = control)
2. Metriche di prestazione del modello:Oltre all'AIC e ai controlli di devianza, si consideri l'analisi ROC (Receiver Operating Characteristic) e si calcoli l'AUC (Area Under the Curve) per valutare la capacità discriminatoria del modello tra le classi di risultati.
library(pROC)
roc_response <- roc(response = my_data$Outcome, predictor = fitted(logistic_model))
auc(roc_response)
3. Analisi dei residui:Esaminare i residui del modello per assicurarsi che non vi siano schemi che possano suggerire una scarsa aderenza del modello al modello stesso, come ad esempio tendenze o raggruppamenti.
plot(residuals(logistic_model, type = "deviance"))
Migliorare il modello di regressione logistica implica bilanciare attentamente l'ingegneria delle funzionalità, la valutazione metodica del modello e il perfezionamento continuo basato su parametri prestazionali. Utilizzando queste tecniche, puoi creare un modello più accurato, robusto e interpretabile che cattura meglio la complessità dei tuoi dati e fornisce previsioni più affidabili.
Applicazioni reali della regressione logistica utilizzando R
La regressione logistica, soprattutto se utilizzata nell'ambiente R, si è rivelata preziosa in un ampio spettro di applicazioni del mondo reale. La sua versatilità nella gestione dei risultati binari lo rende un metodo di riferimento per vari domini che cercano di prendere decisioni informate basate sull'analisi predittiva. Qui, approfondiamo esempi pratici in cui la regressione logistica è stata applicata con successo, facendo luce sulle intuizioni e sulle implicazioni dei suoi risultati.
Sanità e Medicina
In campo medico, la regressione logistica è stata ampiamente utilizzata per prevedere la probabilità che si verifichi una malattia sulla base dei dati dei pazienti. Ad esempio, analizzando le caratteristiche del paziente come età, indice di massa corporea e pressione sanguigna, i modelli di regressione logistica possono prevedere la probabilità di insorgenza del diabete. Questo potere predittivo aiuta gli operatori sanitari a identificare i pazienti ad alto rischio, consentendo strategie di intervento e gestione precoci.
# Predicting diabetes occurrence
diabetes_model <- glm(Diabetes ~ Age + BMI + BloodPressure, family = binomial, data = patient_data)
Servizi finanziari
I settori bancario e finanziario sfruttano la regressione logistica per valutare il rischio di credito. Valutando i dati dei clienti come reddito, storia creditizia e livelli di debito, la regressione logistica aiuta a prevedere la probabilità di insolvenza del prestito. Questa conoscenza è fondamentale affinché gli istituti finanziari possano prendere decisioni informate sui prestiti, minimizzando così i rischi e ottimizzando i processi di approvazione dei prestiti.
# Credit risk assessment
credit_risk_model <- glm(Default ~ Income + CreditHistory + DebtLevel, family = binomial, data = customer_data)
Marketing Analytics
Nel marketing, la regressione logistica prevede il comportamento del cliente, come la probabilità di acquistare un prodotto o di rispondere a una campagna. I modelli di regressione logistica consentono agli esperti di marketing di personalizzare le campagne in modo più efficace analizzando i dati storici di acquisto e le informazioni demografiche, migliorando il coinvolgimento dei clienti e ottimizzando le strategie di marketing.
# Predicting customer purchase behavior
purchase_model <- glm(Purchase ~ Age + Gender + PreviousPurchases, family = binomial, data = sales_data)
Scienze sociali
La regressione logistica viene utilizzata anche nella ricerca sulle scienze sociali, in particolare in aree come l'analisi del comportamento di voto o la comprensione delle tendenze sociali. Esaminando fattori quali età, istruzione e status socioeconomico, i modelli di regressione logistica forniscono informazioni sulla probabilità di determinati comportamenti sociali, contribuendo alla formulazione delle politiche e alla comprensione sociologica.
# Analyzing voting behavior
voting_model <- glm(Voted ~ Age + EducationLevel + SocioEconomicStatus, family = binomial, data = survey_data)
Implicazioni e approfondimenti
Il successo dell'applicazione della regressione logistica in questi ambiti ne sottolinea l'importanza nella modellizzazione predittiva. Quantificare le probabilità di risultati binari sulla base di variabili predittive consente alle parti interessate di prendere decisioni basate sull’evidenza, migliorando l’efficienza e l’efficacia nei rispettivi campi.
Inoltre, le informazioni provenienti dalle analisi di regressione logistica possono portare a misure proattive, formulazioni politiche e aggiustamenti strategici in tutti i settori. Organizzazioni e professionisti possono implementare interventi mirati identificando i principali predittori e comprendendo il loro impatto sui risultati, favorendo risultati positivi e mitigando i rischi.
La regressione logistica tramite R facilita una comprensione più approfondita delle relazioni complesse all'interno dei set di dati. Consente a vari settori di sfruttare l’analisi predittiva per un processo decisionale informato, dimostrando il suo ruolo inestimabile nel portare avanti iniziative basate sui dati in tutto il mondo.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
In questo viaggio completo attraverso la regressione logistica utilizzando R, abbiamo svelato il profondo impatto e la versatilità di questa tecnica statistica in vari campi. Dall’assistenza sanitaria alla finanza e alle scienze sociali, la regressione logistica rappresenta un faro per coloro che cercano di illuminare i modelli nascosti all’interno dei propri dati. Offre una lente predittiva attraverso la quale è possibile prevedere con precisione i risultati binari. Padroneggiare la regressione logistica in R non solo fornisce ad analisti e ricercatori un potente strumento per il processo decisionale basato sui dati, ma favorisce anche un più profondo apprezzamento per l'arte e la scienza della modellazione predittiva. Mentre siamo passati dai concetti fondamentali alle applicazioni avanzate, il valore della regressione logistica nella creazione di strategie e interventi informati è stato abbondantemente chiaro.
Articoli consigliati
Esplora più a fondo il mondo della scienza dei dati con i nostri articoli correlati. Approfondisci più argomenti per ampliare le tue competenze in materia di analisi.
- Regressione logistica Scikit-Learn: una guida completa per scienziati dei dati
- Comprensione delle distribuzioni dei modelli lineari generalizzati
- Quali sono le ipotesi di regressione logistica?
- Quali sono i 3 tipi di regressione logistica?
- Regressione logistica utilizzando Scikit-Learn (Storia)
- Padroneggiare la regressione logistica (Storia)
Domande frequenti (FAQ)
D1: Cos'è la regressione logistica in R?È un metodo statistico per prevedere risultati binari in base a variabili indipendenti.
D2: Perché usare R per la regressione logistica?R offre pacchetti completi come glm() per un'analisi di regressione logistica efficiente e dettagliata.
D3: In che modo la regressione logistica differisce dalla regressione lineare?A differenza della regressione lineare, che prevede valori continui, la regressione logistica prevede risultati binari (0 o 1).
D4: Quali sono i prerequisiti per eseguire la regressione logistica in R?Per l'analisi di regressione logistica è essenziale una conoscenza di base della programmazione in R e dei concetti statistici.
D5: Come interpretare l'output della regressione logistica in R?L'output include i coefficienti, che indicano la relazione tra ciascun predittore e il logaritmo delle probabilità del risultato.
D6: Qual è il ruolo della preelaborazione dei dati nella regressione logistica?La preelaborazione consiste nella pulizia e nella trasformazione dei dati per migliorare l'accuratezza e l'efficienza del modello.
D7: La regressione logistica può gestire variabili categoriche?La regressione logistica può includere variabili categoriche tramite codifica dummy o variabili fattoriali in R.
D8: Come migliorare l'accuratezza di un modello di regressione logistica in R?L'accuratezza del modello può essere migliorata tramite la selezione delle caratteristiche, la gestione della multicollinearità e l'utilizzo di tecniche di regolarizzazione.
D9: Quali sono alcune delle sfide più comuni nella regressione logistica?Le sfide includono la gestione di set di dati sbilanciati, la selezione di caratteristiche rilevanti e la valutazione dell'adeguatezza del modello.
D10: Dove può essere applicata la regressione logistica utilizzando R?Trova ampia applicazione in campi come la medicina, il marketing, la finanza e le scienze sociali per la previsione di risultati binari.