Rilevamento e trattamento dei valori anomali: una guida completa
Imparerai le tecniche essenziali per il rilevamento e il trattamento dei valori anomali, perfezionando i dati per ottenere informazioni veritiere.
Introduzione
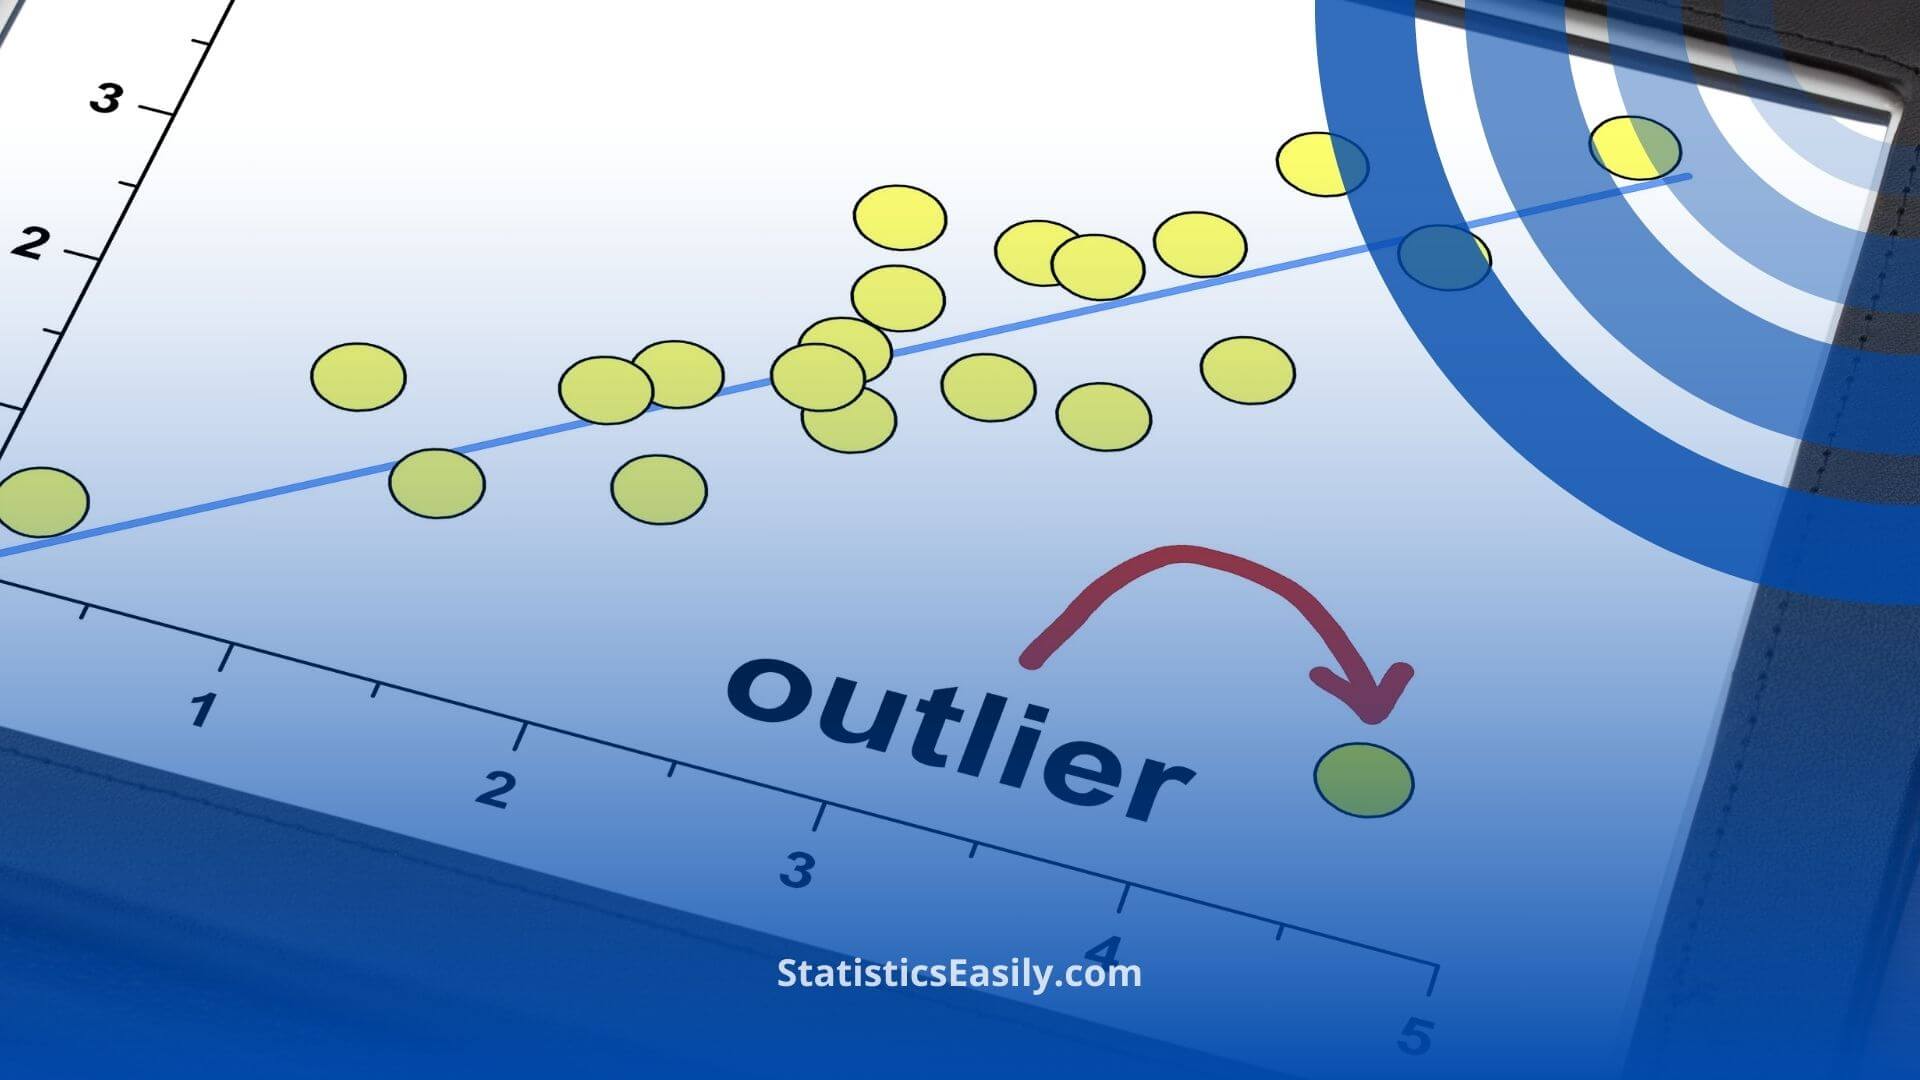
Nella scienza dei dati,rilevamento e trattamento dei valori anomalisono processi fondamentali per salvaguardare l'integrità e l'affidabilità analisi dei dati. Questi valori anomali – punti dati che si discostano significativamente dalla norma – rappresentano una sfida importante, distorcendo i risultati e portando a conclusioni errate. Individuare e gestire i valori anomali non significa semplicemente affinare i dati; significa aderire ai principi di accuratezza e veridicità che guidano la nostra attività scientifica. Questa guida si propone di fornire agli scienziati dei dati le conoscenze e gli strumenti necessari per affrontare la complessità dei valori anomali, garantendo che il loro lavoro rifletta i più elevati standard di integrità statistica e contribuisca al progresso della conoscenza nel settore.
Punti Salienti
- I valori anomali possono distorcere in modo significativo l’analisi dei dati, portando a conclusioni fuorvianti.
- Metodi statistici come Z-score e IQR sono fondamentali per rilevare i valori anomali.
- Gli approcci di machine learning offrono soluzioni avanzate per l'identificazione di valori anomali in set di dati complessi.
- Un trattamento adeguato dei valori anomali può migliorare drasticamente l'accuratezza del modello e le prestazioni predittive.
- Le considerazioni etiche nella gestione dei valori anomali sottolineano l’integrità della scienza dei dati.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendere i valori anomali
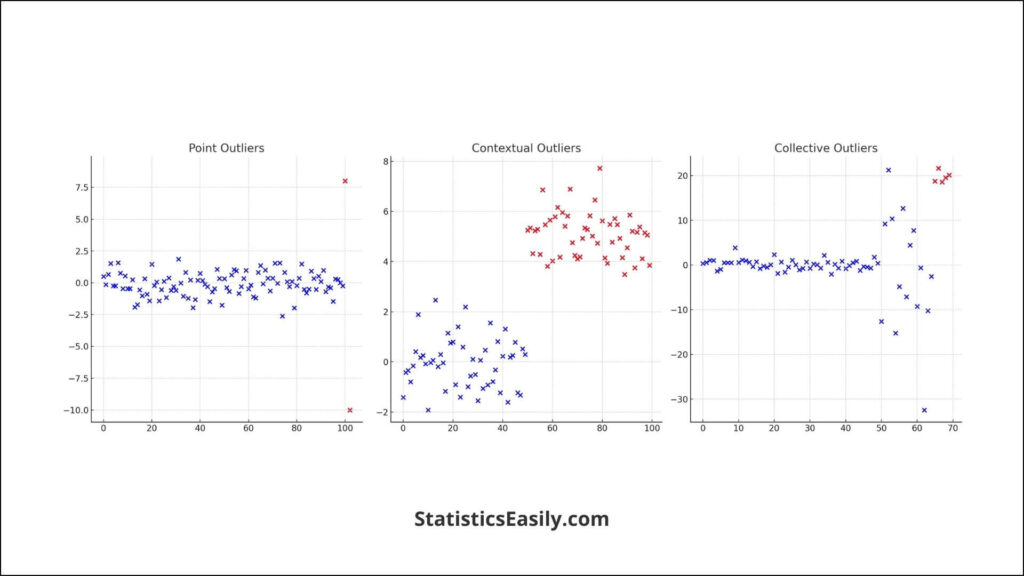
Nella scienza dei dati,valori anomalisono punti dati che si distinguono dal modello collettivo di un dataset. Queste anomalie possono avere un impatto significativo sull'analisi complessiva, portando a risultati distorti e potenzialmente a conclusioni fuorvianti. Esistono principalmente tre tipi di outlier:outlier puntuali, ovvero singoli punti dati molto distanti dal resto dei dati;outlier contestuali, ovvero punti dati considerati anomali in un contesto specifico; eoutlier collettivi, in cui un insieme di punti dati è insolito rispetto all'intero dataset.
Il fondamento teorico dell’analisi dei valori anomali sottolinea il ruolo vitale che il rilevamento e il trattamento dei valori anomali svolgono nel mantenere l’integrità dell’analisi dei dati. I valori anomali possono distorcere le misure statistiche, come la media e la deviazione standard, influenzando così il risultato dell'analisi dei dati. Ad esempio, un singolo valore anomalo può spostare in modo significativo la media, il che potrebbe portare a conclusioni errate sulle tendenze e sui comportamenti dei dati.
Comprendere e identificare questi valori anomali è fondamentale per qualsiasi processo di analisi dei dati affidabile. Riconoscendo e affrontando i valori anomali in modo appropriato, i data scientist possono garantire che le conclusioni tratte dall'analisi dei dati siano accurate e riflettano la vera natura dei dati sottostanti. Questo passaggio non riguarda solo la pulizia dei dati, ma anche la preservazione dell’essenza di ciò che i dati intendono rappresentare, aderendo così ai principi di verità e integrità nel processo scientifico.
Cause dei valori anomali
I valori anomali nei set di dati possono derivare da molteplici fonti, ognuna delle quali richiede un'attenta considerazione per un'analisi accurata dei dati.Gli errori di misurazionesono una causa comune, in cui strumenti o errori umani producono punti dati molto distanti dal valore reale.Gli errori di immissione dei datirappresentano un'altra fonte significativa, spesso dovuti a errori di battitura o a un'errata interpretazione delle unità di misura, che portano a valori anomali, sia alti che bassi. Inoltre,la variabilità naturaledei dati può produrre valori anomali, soprattutto in sistemi complessi in cui si verificano valori estremi inattesi ma reali.
Consideriamo il caso di un esperimento scientifico che misura una particolare concentrazione chimica. Uno spettrometro malfunzionante potrebbe segnalare una concentrazione anormalmente elevata, un valore anomalo derivante da un errore di misurazione. In un altro scenario, un errore di immissione dei dati potrebbe introdurre un valore anomalo quando una cifra in più viene aggiunta accidentalmente a una lettura. Infine, in un set di dati che documenta l’altezza umana, un individuo eccezionalmente alto rappresenta la variabilità naturale, introducendo un valore anomalo che è vero e riflette la diversità della popolazione.
Questi esempi sottolineano l’importanza di discernere la natura dei valori anomali. Anche se l’istinto potrebbe essere quello di rimuoverli, comprenderne le cause può offrire spunti più profondi. Ad esempio, l’anomalia nei dati sulla concentrazione chimica richiede controlli delle apparecchiature, garantendo l’accuratezza futura. L'individuo insolitamente alto nel set di dati sull'altezza può interessare i ricercatori che studiano i fattori genetici che influenzano l'altezza.
Pertanto, l’eliminazione dei valori anomali non dovrebbe essere un processo riflessivo ma un processo ponderato, considerando il contesto e la causa. Questo approccio garantisce che l’analisi dei dati rimanga fondata sulla verità, riflettendo accuratamente la realtà sottostante e incarnando i principi di integrità e completezza nell’indagine scientifica.
Tecniche di rilevamento
Il rilevamento dei valori anomali è un passaggio essenziale nell’analisi dei dati, garantendo l’accuratezza e l’affidabilità dei modelli statistici. Sono stati sviluppati vari metodi per identificare efficacemente queste anomalie.
Metodi statistici:
Il punteggio Zè uno dei metodi più comuni per individuare i valori anomali. Questa tecnica misura il numero di deviazioni standard che un punto dati si discosta dalla media. In genere, i punti dati con un punteggio Z superiore a ±3 sono considerati valori anomali.
Gamma interquartile (IQR)si calcola considerando la differenza tra il primo (25° percentile) e il terzo quartile (75° percentile) dei dati. I valori anomali vengono quindi identificati come punti dati che si trovano al di sotto del primo quartile o al di sopra del terzo quartile di 1.5 volte l'IQR.
Il test di Grubbs, o test del residuo normalizzato massimo, rileva un singolo valore anomalo in un set di dati. Questo test presuppone una distribuzione normale ed è più indicato quando si sospetta la presenza di un solo valore anomalo.
Approcci di apprendimento automatico:
L'apprendimento automatico offre tecniche avanzate per identificare i valori anomali in grandi insiemi di dati. Algoritmi comeIsolation ForestseDBSCAN (Density-Based Spatial Clustering of Applications with Noise)sono particolarmente efficaci nel rilevare anomalie, considerando la distribuzione e la densità dei dati.
Casi studio:
Un'applicazione notevole del rilevamento di valori anomali èil rilevamento delle frodi. Gli istituti finanziari utilizzano modelli di apprendimento automatico per identificare transazioni insolite che si discostano significativamente dalle abitudini di spesa di un cliente e che potrebbero indicare una frode.
In ambito sanitario, i metodi di rilevamento degli outlier monitorano le risposte insolite ai trattamenti. Ad esempio, una reazione avversa inattesa a un farmaco durante una sperimentazione clinica potrebbe essere un outlier, segnalando la necessità di ulteriori indagini.
Anche il campo dellescienza ambientaletrae vantaggio dall'individuazione di valori anomali. I ricercatori possono identificare e studiare cambiamenti anomali nei dati climatici, come improvvisi picchi di temperatura o di precipitazioni, per comprendere meglio le dinamiche del cambiamento climatico.
Strategie di trattamento e gestione
L’identificazione dei valori anomali è solo il primo passo nell’analisi dei dati. Il modo in cui trattiamo e gestiamo questi valori anomali è una decisione fondamentale che influenza in modo significativo il risultato e l’integrità del nostro studio. Le strategie per il trattamento dei valori anomali includono la rimozione, la trasformazione e l'imputazione, ciascuna con il proprio contesto di applicazione e le proprie implicazioni.
La rimozioneè l'approccio più semplice, ma va applicata con cautela. Eliminare punti dati può comportare la perdita di informazioni preziose o la distorsione dei risultati. Questo metodo è generalmente riservato a errori evidenti o quando l'influenza di un valore anomalo è sproporzionatamente grande rispetto alla sua rilevanza.
Trasformazioneconsiste nell'applicare funzioni matematiche per ridurre l'asimmetria introdotta dai valori anomali. Le trasformazioni più comuni includono il logaritmo, la radice quadrata o la trasformazione reciproca. Questo metodo aiuta a normalizzare la distribuzione dei dati, consentendo un'analisi più efficace senza dover rimuovere direttamente i punti dati.
Imputazionesostituisce i valori anomali con valori stimati, in genere tramite mediana, media o metodi di regressione. Questa strategia è appropriata quando si ritiene che il dato sia errato ma indicativo di una tendenza di fondo che dovrebbe essere affrontata.
Considerazioni etiche:
L’integrità del processo decisionale nel trattamento dei valori anomali deve essere bilanciata. Ogni strategia ha il suo posto, ma la scelta deve essere giustificata eticamente e scientificamente. Rimuovere un punto dati perché scomodo mette a dura prova la ricerca della verità, così come la trasformazione o l'imputazione indiscriminata senza comprendere la natura dei dati. La pratica etica richiede trasparenza su come vengono trattati i valori anomali e il riconoscimento del potenziale impatto sulle conclusioni dell'analisi.
Ad esempio, rimuovere i valori anomali dai dati sull’inquinamento senza indagarne le cause nelle scienze ambientali potrebbe mascherare significative minacce ecologiche. Allo stesso modo, le risposte anomale dei pazienti al trattamento sanitario potrebbero rivelare informazioni cruciali sugli effetti collaterali o su nuovi percorsi terapeutici.
In definitiva, il trattamento e la gestione dei valori anomali non dovrebbero mirare solo a dati più puliti o a percorsi di analisi più confortevoli, ma dovrebbero riflettere l’impegno a scoprire e comprendere le verità sottostanti all’interno dei dati. Questo impegno garantisce che il nostro lavoro faccia avanzare la conoscenza con integrità e rispetto per i fenomeni che cerchiamo di comprendere.
Strumenti e software per il rilevamento di valori anomali
Vari strumenti e software sono emersi come alleati indispensabili per i data scientist nel tentativo di identificare e gestire i valori anomali. Questi strumenti, dotati di algoritmi sofisticati e interfacce intuitive, migliorano l’accuratezza del rilevamento dei valori anomali e semplificano il processo di trattamento, sostenendo così la ricerca scientifica della verità.
Librerie Python:
- Scikit-learn: Rinomato per le sue funzionalità complete di apprendimento automatico, scikit-learn offre metodi pratici per il rilevamento di valori anomali, come Isolation Forest e Local Outlier Factor (LOF). La sua versatilità e facilità di integrazione lo rendono un punto fermo nel toolkit del data scientist.
- PyOD: Una libreria specializzata dedicata al rilevamento dei valori anomali, PyOD include un'ampia gamma di algoritmi di rilevamento, dagli approcci classici come ABOD (Angle-Based Outlier Detection) ai modelli contemporanei basati su reti neurali. L'API coerente di PyOD e l'integrazione con scikit-learn facilitano un'esperienza di analisi senza soluzione di continuità.
Pacchetti R:
- Rilevamento valori anomali: questo pacchetto fornisce strumenti per rilevare e gestire valori anomali nei dati univariati e multivariati. È particolarmente apprezzato per le sue robuste tecniche statistiche e l'adattabilità a vari tipi di dati.
- mvoutlier: Specializzato in dati multivariati, mvoutlier offre metodi grafici e statistici per identificare i valori anomali. È uno strumento essenziale per set di dati complessi in cui i valori anomali potrebbero richiedere tempo per essere evidenti.
Piattaforme software:
- KNIME:Un software basato su un'interfaccia utente grafica che consente flussi di lavoro sofisticati di analisi dei dati, incluso il rilevamento di valori anomali. La sua struttura modulare incorpora metodi statistici classici e algoritmi avanzati di apprendimento automatico.
- Quadro: Noto per la sua abilità nella visualizzazione dei dati, Tableau include anche funzionalità per il rilevamento dei valori anomali, principalmente attraverso l'analisi visiva. Questa funzionalità consente agli utenti di identificare rapidamente le anomalie all'interno di set di dati di grandi dimensioni osservando le deviazioni nelle rappresentazioni grafiche.
—
Il ruolo dei valori anomali nella modellazione predittiva e nel machine learning
I valori anomali occupano una posizione sfumata nella modellazione predittiva e nell’apprendimento automatico, incidendo in modo significativo sull’accuratezza del modello e sulle prestazioni predittive. Comprendere il loro ruolo è fondamentale per sviluppare modelli robusti e allineati alla verità dei dati che rappresentano.
Impatto sull'accuratezza e sulle prestazioni del modello
I valori anomali possono influenzare notevolmente il processo di addestramento dei modelli predittivi. Ad esempio, i valori anomali possono distorcere la linea di regressione nei modelli di regressione lineare, portando a scarse prestazioni del modello sul set di dati generale. Negli algoritmi di clustering, i valori anomali possono alterare i centri dei cluster, influenzando la capacità del modello di raggruppare accuratamente i punti dati.
Gestione dei valori anomali nell'addestramento del modello
L'approccio alla gestione dei valori anomali deve essere considerato attentamente durante l'addestramento del modello. Le opzioni includono:
- esclusione: rimozione dei valori anomali dal set di dati prima dell'addestramento, che può essere appropriata quando i valori anomali sono errori confermati senza significato di fondo.
- Trasformazione: L'applicazione di trasformazioni matematiche per ridurre la gamma di punti dati rende i valori anomali meno pronunciati e potenzialmente migliora la robustezza del modello senza rimozione completa.
- Metodi robusti: Utilizzo di modelli e algoritmi progettati per essere meno sensibili ai valori anomali, come foreste casuali o metodi di regressione robusti.
Garantire che i modelli siano robusti e veritieri
L'integrità dell'addestramento del modello risiede nel bilanciare l'eliminazione del rumore con la conservazione di dati preziosi. I veri valori anomali legati alla variabilità non dovrebbero essere rimossi frettolosamente, ma invece compresi per gli spunti che possono offrire. Questa comprensione può portare a modelli più accurati e che riflettono maggiormente la complessità e la verità dei fenomeni sottostanti.
Linee guida per la gestione dei valori anomali
- Analisi e documentazione: analizzare approfonditamente i valori anomali per determinarne la causa e documentare le decisioni prese in merito alla loro gestione.
- Convalida: utilizzare tecniche di convalida incrociata per garantire che il modello funzioni bene su dati invisibili e che le strategie di gestione dei valori anomali migliorino la generalizzabilità del modello.
- Monitoraggio continuo: Anche dopo l'implementazione, i modelli dovrebbero essere continuamente monitorati per garantire che rimangano efficaci anche quando vengono introdotti nuovi dati, che potrebbero contenere valori anomali nuovi e informativi.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
Il percorso attraverso il rilevamento e il trattamento dei valori anomali è fondamentale nella scienza dei dati, poiché garantisce l'integrità e l'affidabilità dell'analisi dei dati. È una testimonianza dell'impegno dei data scientist nel raggiungere l'accuratezza e nel sostenere la verità nei loro sforzi scientifici. Come abbiamo esplorato, l’attenta identificazione, analisi e trattamento dei valori anomali non solo perfeziona i nostri dati ma approfondisce anche la nostra comprensione, rivelando intuizioni che altrimenti potrebbero rimanere oscurate. Questa guida completa sottolinea la necessità di affrontare i valori anomali con un equilibrio tra conoscenza tecnica e considerazione etica, allineando le nostre pratiche con il perseguimento più eccellente di rivelare la verità nei dati. Lasciamo che questa guida ispiri una continua ricerca di conoscenza e di applicazione dei principi etici nel trattamento dei valori anomali, promuovendo una cultura di integrità e completezza nella comunità scientifica.
Articoli consigliati
Scopri di più su come affinare la tua abilità analitica. Leggi i nostri articoli correlati sulle tecniche avanzate di data science e migliora le tue conoscenze oggi stesso!
- Esplorazione delle basi dei modelli lineari generalizzati: un'introduzione completa
- Accuratezza, precisione, richiamo o F1: quale metrica prevale?
- Istogramma inclinato a destra: dati asimmetrici (Storia)
- Test t accoppiati principali (Storia)
- Esempio di t-test accoppiato
Domande frequenti (FAQ)
D1: Cosa sono esattamente i valori anomali nell'analisi dei dati?I valori anomali sono punti dati che differiscono significativamente dalle altre osservazioni, potenzialmente distorcendo le analisi e i risultati statistici.
D2: Perché l'individuazione e il trattamento dei valori anomali sono importanti?Identificare e trattare i valori anomali è fondamentale per un'analisi accurata dei dati, garantendo che i modelli riflettano i veri schemi sottostanti.
D3: I valori anomali possono mai essere considerati dati preziosi?I valori anomali possono rivelare nuove informazioni o errori nella raccolta dei dati e la loro interpretazione spesso richiede un'analisi accurata.
D4: Quali sono i metodi standard per individuare i valori anomali?Il punteggio Z e l'intervallo interquartile (IQR) sono metodi statistici molto diffusi.
D5: Come gestiscono i modelli di apprendimento automatico i valori anomali?A seconda dell'algoritmo, i modelli di apprendimento automatico possono richiedere una preelaborazione per ridurre al minimo l'impatto dei valori anomali o possono gestirli intrinsecamente.
D6: Qual è l'impatto dei valori anomali sulla modellazione predittiva?I valori anomali possono distorcere le previsioni del modello se non gestiti adeguatamente, portando a risultati meno accurati o distorti.
D7: Esistono strumenti automatizzati per il rilevamento degli outlier?Diversi strumenti e pacchetti software sono progettati specificamente per rilevare e trattare gli outlier nei set di dati.
D8: In che modo il trattamento dei valori anomali varia a seconda del tipo di dati?Le strategie di trattamento possono includere trasformazione dei dati, la rimozione o l'imputazione dei dati, a seconda della natura dei dati e degli obiettivi dell'analisi.
D9: Quali considerazioni etiche sorgono nel trattamento dei valori anomali?Le considerazioni etiche includono la garanzia dell'integrità dei dati e l'evitare manipolazioni che potrebbero falsare i risultati o le conclusioni.
D10: Come posso approfondire le mie conoscenze in materia di individuazione e gestione dei valori anomali?Partecipare a corsi avanzati di data science, tutorial e progetti pratici può aiutare ad approfondire la comprensione e le competenze nell'analisi dei valori anomali.