Guida alla selezione della distribuzione e della funzione di collegamento del modello lineare generalizzato (GLM).
Imparerai a selezionare la distribuzione del modello lineare generalizzato e la funzione di collegamento per una precisione di modellazione ottimale.
Introduzione
I modelli lineari generalizzati (GLM) rappresentano un'estensione dei tradizionali modelli di regressione lineare progettati per accogliere un'ampia gamma di tipi di dati e modelli di distribuzione. Questa flessibilità rende i GLM indispensabili nell’arsenale di data scientist e statistici. Fondamentalmente, i GLM sono costituiti da tre componenti principali:
- The componente casuale specifica la distribuzione di probabilità della variabile di risposta;
- The componente sistematica mette in relazione i predittori con la risposta attraverso una funzione di predittore lineare;
- The funzione di collegamento collega la media della distribuzione con il predittore lineare.
La scelta di una distribuzione e di una funzione di collegamento appropriateDistribuzione del modello lineare generalizzato e funzione di collegamentonon è una mera decisione tecnica; è un'arte che migliora l'accuratezza e le prestazioni predittive del modello. Comprendere come abbinare la distribuzione e la funzione di collegamento alle caratteristiche intrinseche dei dati è fondamentale per sfruttare appieno il potenziale dei GLM, ottenendo analisi più approfondite e affidabili. Questa guida si propone di illustrare il percorso verso una configurazione ottimale del modello, garantendo che il vostro GLM catturi la vera essenza dei vostri dati.
Punti Salienti
- La scelta della corretta distribuzione GLM migliora significativamente la precisione del modello.
- Le funzioni di collegamento trasformano le previsioni del modello nella scala della variabile di risposta.
- La distribuzione binomiale con un collegamento logit è ideale per i dati di risultati binari.
- L'adattamento del modello migliora abbinando la distribuzione alla natura dei dati.
- Il test iterativo delle funzioni di collegamento può svelare le migliori prestazioni del modello.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendere la distribuzione GLM
I modelli lineari generalizzati (GLM) sono un pilastro dell'analisi statistica, in grado di adattarsi a un'ampia gamma di tipologie di dati grazie alla loro struttura flessibile. Al centro della loro utilità vi è il concetto didistribuzione GLM, che permette a questi modelli di superare i limiti della regressione lineare tradizionale, abbracciando distribuzioni diverse da quella normale. Questa sezione approfondisce le diverse distribuzioni alla base dei GLM e vi guida nell'individuazione delladistribuzione GLM.
Distribuzioni diverse per tipi di dati diversi
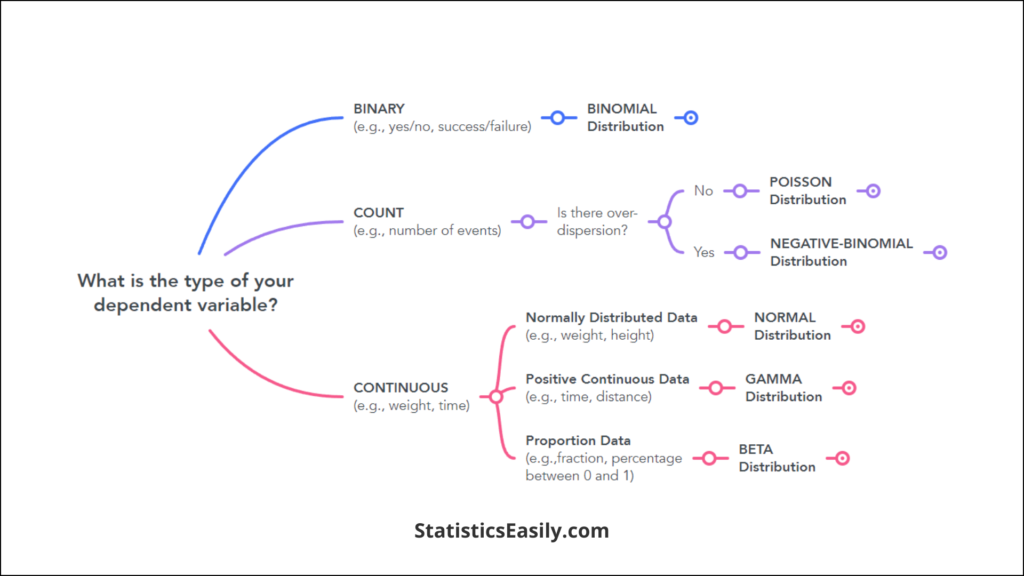
I GLM sono progettati unicamente per gestire diverse distribuzioni di dati, ciascuna delle quali soddisfa tipi specifici di variabili di risposta. La distribuzione binomiale viene spesso utilizzata per risultati binari, come scenari di successo/fallimento. Al contrario, la distribuzione di Poisson è fondamentale per il conteggio dei dati, affrontando “quanti?”. Per dati continui che aderiscono a valori positivi, la distribuzione Gamma offre un modello appropriato. Ogni distribuzione è personalizzata per catturare l'essenza della struttura dei dati sottostante, garantendo che le ipotesi del modello siano in linea con il comportamento naturale dei dati.
Adattare il modello ai tuoi dati
La scelta delladistribuzione GLMpiù appropriata non è un processo univoco, ma una decisione complessa che ha un impatto significativo sull'accuratezza e sull'interpretabilità del modello. La chiave sta nel comprendere la distribuzione dei dati e le sue caratteristiche intrinseche. Ad esempio, la distribuzione di Poisson potrebbe essere il punto di partenza ideale se i dati rappresentano conteggi o tassi. Al contrario, la distribuzione binomiale potrebbe essere più adatta per dati binari o proporzionali. Questo processo di selezione è fondamentale, poiché garantisce che il GLM rifletta i processi reali che generano i dati, migliorando le capacità predittive e l'interpretabilità del modello.
Abbinando con cura i dati alla correttadistribuzione GLM, si aumenta il rigore analitico dello studio, aprendo la strada a risultati più precisi e significativi. Questo passaggio fondamentale è determinante per sfruttare appieno il potenziale dei GLM, consentendo loro di rivelare le complesse storie nascoste nei dati.
Il ruolo delle funzioni di collegamento nei GLM
Le funzioni di collegamento sono i cardini dei modelli lineari generalizzati (GLM), che fungono da ponte critico tra i predittori lineari e il valore atteso della variabile di risposta. Il loro ruolo non può essere sopravvalutato, poiché consentono di modellare un'ampia gamma di tipi di dati oltre le capacità della tradizionale regressione lineare. Trasformando le previsioni nella scala della variabile di risposta, le funzioni di collegamento assicurano che gli output del modello aderiscano all'intervallo e alla distribuzione dei dati appropriati, migliorando così l'interpretabilità e l'accuratezza delle previsioni del modello.
Trasformare le previsioni in realtà: l'essenza delle funzioni di collegamento
Le funzioni di collegamento non sono universali; vengono selezionate con cura in base alla natura della variabile di risposta e alla distribuzione scelta per il modello lineare generalizzato (GLM). Le funzioni di collegamento standard includono la funzionelogit, ampiamente utilizzata nella regressione logistica per dati binari, che trasforma le probabilità in una scala continua illimitata. La funzione di collegamentoidentità, tipica dei modelli di distribuzione normale, presuppone una relazione diretta tra i predittori e la variabile di risposta. La funzione di collegamento logaritmica è tipica dei dati di conteggio modellati con una distribuzione di Poisson, garantendo che le previsioni del modello rimangano positive e continue.
Applicazioni delle funzioni di collegamento: dalla teoria alla pratica
La scelta della funzione di collegamento ha profonde implicazioni per l'applicazione e l'interpretazione del modello. Ad esempio, in epidemiologia, il collegamento logit nella regressione logistica modella le probabilità che si verifichi un evento, come la presenza o l’assenza di una malattia. In economia, il collegamento identitario nei modelli di regressione lineare prevede direttamente risultati quantitativi come il reddito sulla base di predittori come l’istruzione e l’esperienza. Nel frattempo, nel settore assicurativo, il collegamento esponenziale nei sinistri dei modelli di regressione di Poisson conta, garantendo che le previsioni siano non negative e discrete.
Selezionando e applicando abilmente la funzione di collegamento appropriata, statistici e data scientist possono creare GLM che catturano i modelli sottostanti nei loro dati e trasmettono i risultati in modo accurato e intuitivamente comprensibile al loro pubblico. Questa sezione della guida demistifica la selezione e l'applicazione delle funzioni di collegamento, fornendoti le conoscenze per migliorare la precisione e l'interpretabilità dei tuoi GLM.
Selezionare la giusta distribuzione e funzione di collegamento
La sceltaDistribuzione del modello lineare generalizzato e funzione di collegamentoè fondamentale per il successo della vostra analisi statistica. La natura della variabile di risposta e la relazione tra la variabile di risposta e i predittori guidano questa scelta. Qui forniamo una guida dettagliata per aiutarvi a orientarvi in questo processo cruciale.
Passaggio 1: identificazione del tipo di variabile di risposta
Il primo passo nella scelta della distribuzione corretta è identificare chiaramente il tipo di dati con cui stai lavorando:
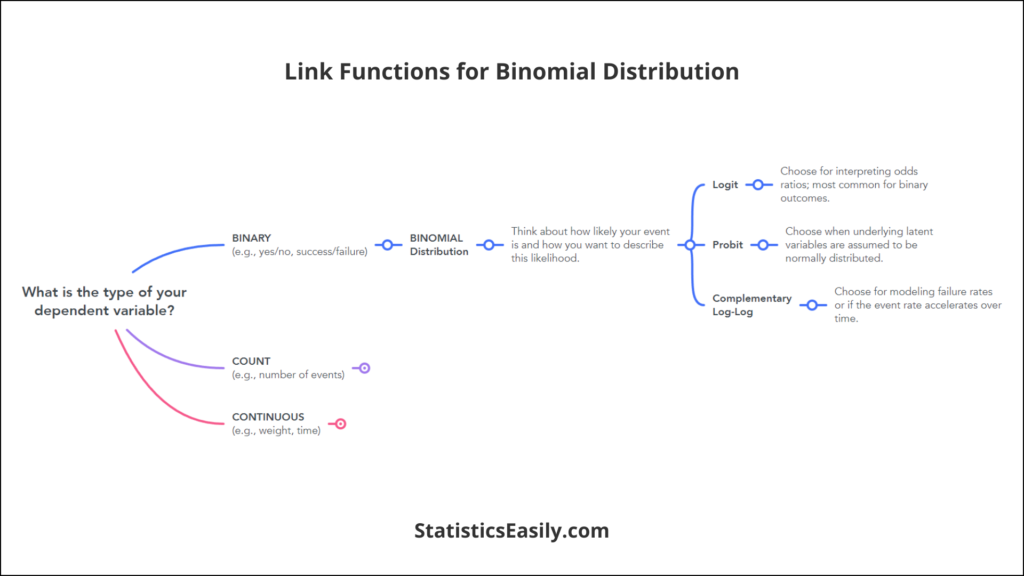
- Dati binari: Per i risultati che rientrano in una delle due categorie (ad esempio, successo/fallimento, sì/no), ilDistribuzione binomialeè la scelta giusta. Questa distribuzione modella il numero di successi in una serie di prove indipendenti.
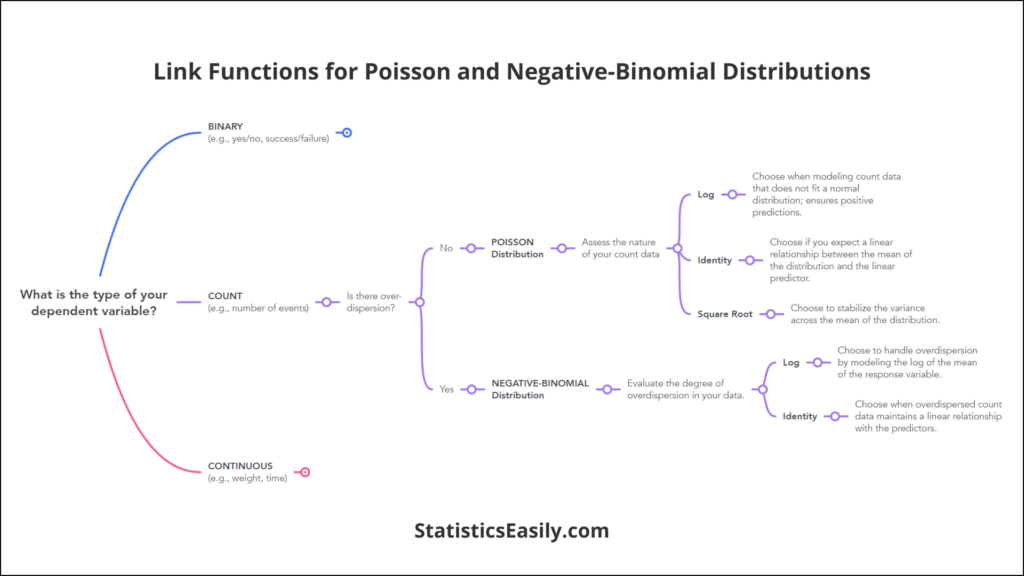
- Contare i dati: Ildistribuzione di Poissonssonviene tipicamente utilizzato quando si ha a che fare con eventi numerabili (ad esempio, il numero di eventi in un dato tempo o spazio). È ideale per i dati che rappresentano conteggi e sono numeri interi non negativi.
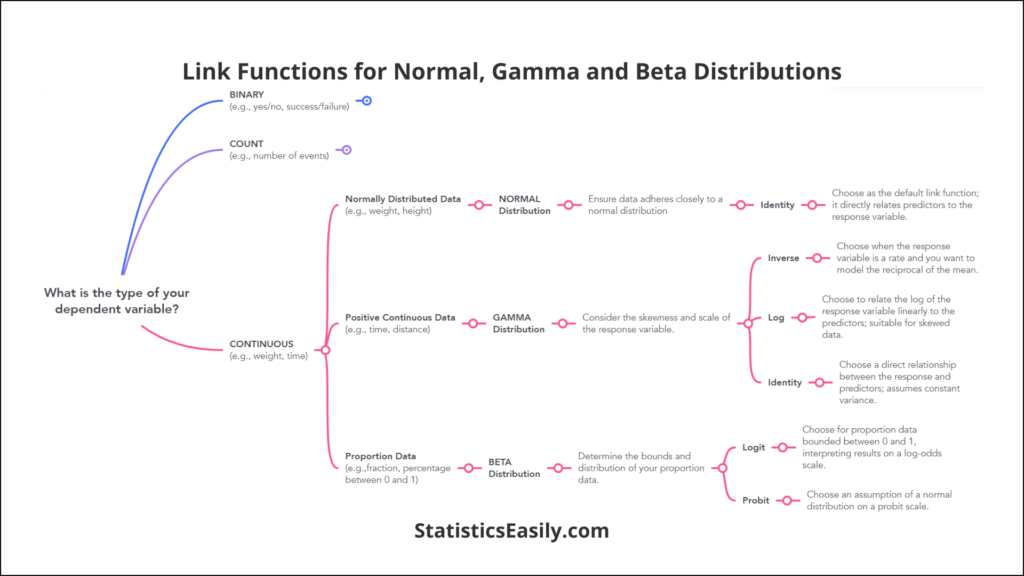
- Dati continui: Ildistribuzione Gammaè spesso adatto per i dati che assumono qualsiasi valore all'interno di un intervallo, in particolare numeri positivi come durate o importi. Viene utilizzato per modellare dati distorti positivamente.
- Dati normalmente distribuiti: quando i dati seguono approssimativamente una distribuzione normale, soprattutto nel caso di risultati continui che possono assumere valori sia positivi che negativi,Distribuzione normalepuò essere applicato nel quadro GLM.
Passaggio 2: comprendere la relazione tra le variabili
La funzione di collegamento collega il predittore lineare alla media della distribuzione della risposta. Dovrebbe essere scelto in base a come prevedi che i cambiamenti nei tuoi predittori influenzino la variabile di risposta:
- Per dati binari: IlCollegamento LogitLa funzione è comunemente usata, trasformando la combinazione lineare di predittori in modo che sia compresa tra 0 e 1, rappresentando così le probabilità.
- Per i dati di conteggio: IlCollegamento al registroLa funzione è una scelta naturale, soprattutto con la distribuzione di Poisson, poiché garantisce che le previsioni siano sempre positive e adatte ai dati di conteggio.
- Per dati continui con inclinazione positiva (Gamma): IlCollegamento inversola funzione può essere utile quando si modellano tariffe o tempi, garantendo previsioni positive.
- Per dati normalmente distribuiti: IlCollegamento identitarioviene spesso utilizzata la funzione , che implica una relazione diretta tra i predittori e la variabile di risposta. Questa semplice funzione implica che il valore atteso della risposta è uguale al predittore lineare.
Passaggio 3: applicazione della diagnostica del modello
Dopo aver selezionato una funzione di distribuzione e collegamento preliminare in base ai criteri di cui sopra, è fondamentale convalidare la scelta attraverso la diagnostica del modello:
- Analisi residua: Esaminare i residui per individuare modelli che potrebbero suggerire un adattamento inadeguato, indicando la necessità di una diversa distribuzione o funzione di collegamento.
- Test di bontà di adattamento: utilizza test come Devianza o AIC per valutare quanto bene il tuo modello si adatta quantitativamente ai dati. Questi test possono guidarti nel confrontare diversi modelli o configurazioni per trovare la soluzione migliore.
Perfezionamento iterativo
Il processo di selezione della corretta funzione di distribuzione e collegamento è spesso iterativo. In base alla diagnostica, potrebbe essere necessario rivedere le proprie scelte, provare diverse distribuzioni o funzioni di collegamento finché la diagnostica non indica una buona soluzione.
Seguendo questi passaggi dettagliati, sarai meglio attrezzato per selezionare la funzione di distribuzione e collegamento più appropriata per il tuo GLM, migliorando l'accuratezza e l'interpretabilità del modello.
| Tipo di variabile di risposta | Distribuzione suggerita | Funzioni di collegamento comuni | Usa caso |
|---|---|---|---|
| Risultato binario (ad esempio, successo/fallimento) | la distribuzione binomiale | Logit, Probit, Log-Log complementare | Modellazione delle probabilità di risultati binari, come la presenza/assenza di una malattia. |
| Conteggio dei dati (ad esempio, numero di eventi) | Poisson | Log, Identità, Radice Quadrata | Conteggio degli eventi a intervalli fissi, ad esempio il numero di chiamate ricevute da un call center all'ora. |
| Contare i dati con sovradispersione | Binomiale negativo | Registro, identità | Contare i dati che presentano una variabilità superiore alle ipotesi di Poisson, come il numero di sinistri assicurativi per cliente. |
| Proporzioni continue | beta | Logit, Probit | Proporzioni che variano tra 0 e 1, come la frazione di un'area interessata da una determinata condizione. |
| Dati continui positivi | gamma | Inverso, Log, Identità | Modellazione dei tempi di attesa o di servizio, dove la variabile di risposta è sempre positiva. |
| Dati normalmente distribuiti | Normale (gaussiano) | Identità | Risultati continui distribuiti simmetricamente, come punteggi o punteggi dei test. |
Suggerimenti pratici per l'ottimizzazione GLM
Implementare efficacemente i modelli lineari generalizzati (GLM) inRePythonrichiede la comprensione delle sfumature di questi potenti strumenti. Sfruttando in modo appropriato laDistribuzione del modello lineare generalizzato e funzione di collegamento, è possibile perfezionare i modelli per ottenere maggiore accuratezza e una migliore interpretabilità. Ecco alcuni suggerimenti pratici per guidarvi in questo processo:
Best practice per l'implementazione di GLM in R:
1. Utilizzare la‘glm()‘funzione' : la funzione 'glm()' di R è versatile e consente di specificare la formula del modello, la famiglia di distribuzione e la funzione di collegamento. Ad esempio, 'glm(response ~ predictors, family=binomial(link=”logit”), data=mydata)' adatterà un modello di regressione logistica.
2. Diagnostica con‘plot()‘e‘summary()': Dopo aver adattato il modello, utilizzare 'summary(glm_model)' per ottenere un riepilogo dettagliato dei coefficienti del modello, dei livelli di significatività e altro ancora. La funzione 'plot(glm_model)' può fornire grafici diagnostici per valutare l'adattamento e verificare le ipotesi.
3. Selezione del modello con AIC: utilizzare la funzione 'step()' per eseguire la selezione graduale del modello basata sul Criterio di Informazione di Akaike (AIC), che consente di scegliere un modello che bilanci la complessità con la bontà dell'adattamento.
4. Convalida incrociata: per la convalida del modello, si consiglia di utilizzare pacchetti come 'caret' o 'cv.glm()' del pacchetto boot per eseguire la convalida incrociata e valutare le prestazioni predittive del modello.
Migliori pratiche per l'implementazione di GLM in Python:
1. Sfrutta‘statsmodels‘o‘scikit-learn': Python offre diverse librerie per l'implementazione di GLM. Per un approccio più statistico, 'statsmodels' fornisce riepiloghi dettagliati e strumenti diagnostici. Per un approccio di apprendimento automatico, 'scikit-learn' offre semplicità e integrazione con i flussi di lavoro di ML.
2. Adattamento del modello con‘statsmodels': utilizzare 'statsmodels.api.GLM' per adattare un GLM, specificando la famiglia e la funzione di collegamento. Ad esempio, 'GLM(y, X, family=sm.families.Binomial(sm.families.links.logit)).fit()' adatta una regressione logistica.
3. Diagnostica e validazione: utilizzare 'statsmodels‘ ' per tecniche come la convalida incrociata.sklearn.model_selection‘ per tecniche come la cross-validation.
4. Selezione delle caratteristiche: in 'scikit-learn', è possibile utilizzare le tecniche di regolarizzazione disponibili nelle implementazioni di regressione logistica ('LogisticRegressionCV') per eseguire la selezione delle caratteristiche e prevenire l'overfitting.
Perfezionamento del modello utilizzando la funzione di distribuzione e collegamento:
Perfezionamento iterativo: la costruzione del modello è un processo iterativo. Inizia con un modello semplice e aggiungi gradualmente complessità. Utilizza strumenti diagnostici in ogni fase per valutare le prestazioni del modello e prendere decisioni informate sulle modifiche da apportare.
Selezione della distribuzione: scegli la distribuzione che meglio si adatta alla natura della tua variabile di risposta. Per risultati binari, inizia con una distribuzione binomiale; per dati di conteggio, considera la distribuzione di Poisson o la distribuzione binomiale negativa in caso di sovradispersione.
Scelta della funzione di collegamento: La funzione di collegamento dovrebbe riflettere la relazione tra i predittori lineari e la scala di risposta. Ad esempio, utilizzare una funzione di collegamento logit per le probabilità in un modello binomiale o una funzione di collegamento logaritmica per i dati di conteggio in un modello di Poisson.
Validazione e diagnostica: Eseguire regolarmente la diagnostica del modello per verificare la presenza di problemi quali non linearità, punti di leva elevati o eteroschedasticità. Utilizzare grafici dei residui, grafici di influenza e la distanza di Cook per identificare potenziali problemi.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
Giunti alla conclusione del nostro percorso attraverso le complessità dellaDistribuzione del modello lineare generalizzato e funzione di collegamentodella selezione della funzione di collegamento, è fondamentale ripercorrere le intuizioni chiave che migliorano la precisione dei nostri modelli statistici e la profondità delle nostre analisi. Questa guida ha illustrato il percorso per sfruttare appieno il potenziale dei modelli lineari generalizzati, sottolineando l'importanza cruciale di abbinare i componenti del modello alle caratteristiche intrinseche dei dati.
Punti Salienti:
Approccio personalizzato: l'essenza dell'ottimizzazione GLM risiede nella selezione ponderata della distribuzione e della funzione di collegamento, adattate alla natura della variabile di risposta e alla relazione prevista con i predittori. Dai risultati binari che richiedono una distribuzione binomiale abbinata a una funzione di collegamento logit, ai dati di conteggio che si prestano meglio a essere modellati da una distribuzione di Poisson e una funzione di collegamento logaritmica, ogni scelta gioca un ruolo fondamentale nell'accuratezza del modello.
Diagnosi e iterazione: il percorso non si conclude con la selezione iniziale. La diagnostica è fondamentale per perfezionare il modello, con l'analisi dei residui e i test di bontà dell'adattamento che guidano le modifiche iterative per garantire il miglior adattamento possibile del modello.
Applicazione nel mondo reale: la vera prova di questi principi risiede nella loro applicazione a dati reali. La versatilità dei modelli lineari generalizzati (GLM) consente di adattarli a una vasta gamma di scenari, dagli studi epidemiologici che prevedono l'incidenza delle malattie ai modelli econometrici che valutano le tendenze di mercato.
Articoli consigliati
Scopri ulteriori approfondimenti e tecniche avanzate nella nostra raccolta completa di articoli sulla modellazione statistica e analisi dei dati . Immergiti nel mondo della scienza dei dati con le nostre guide esperte.
- Esplorazione delle basi dei modelli lineari generalizzati: un'introduzione completa
- Guida alla selezione della distribuzione e della funzione di collegamento del modello lineare generalizzato (GLM).
- Comprensione delle distribuzioni dei modelli lineari generalizzati
- Il ruolo delle funzioni di collegamento nei modelli lineari generalizzati
Domande frequenti (FAQ)
D1: Cos'è un modello lineare generalizzato (GLM)?Un GLM è una generalizzazione flessibile della regressione lineare ordinaria che consente alle variabili di risposta di avere modelli di distribuzione degli errori diversi dalla distribuzione normale.
D2: Perché è importante scegliere la distribuzione corretta nei GLM?La selezione della distribuzione appropriata aiuta a modellare accuratamente i dati, riflettendone la struttura e la variabilità sottostanti.
D3: Cosa sono le funzioni di collegamento nei GLM?Le funzioni di collegamento definiscono la relazione tra il predittore lineare e la media della funzione di distribuzione.
D4: Come scelgo la funzione di collegamento più adatta per il mio modello GLM?La scelta della funzione di collegamento dipende dalla natura della variabile dipendente e dalla distribuzione dei dati.
D5: Posso utilizzare più distribuzioni in un singolo GLM?In genere, in un GLM si sceglie una singola distribuzione per adattarla al meglio ai dati, ma i modelli complessi possono integrare diverse distribuzioni.
D6: Qual è la distribuzione più comune utilizzata nei GLM?La distribuzione binomiale è ampiamente utilizzata per i dati binari, mentre la distribuzione normale è tipica per i dati continui.
D7: Che ruolo giocano gli strumenti diagnostici nella distribuzione GLM e nella selezione della funzione di collegamento?Gli strumenti diagnostici aiutano a valutare l'adattamento del modello, a identificare la presenza di valori anomali e a guidare il processo di selezione.
D8: Gli strumenti software possono aiutare a selezionare la distribuzione GLM e la funzione di collegamento?Sì, i software statistici come R e Python offrono pacchetti che facilitano la selezione e la valutazione dei GLM.
D9: In che modo la scelta della funzione di collegamento influisce sull'interpretazione del modello?La funzione di collegamento influenza il modo in cui vengono interpretati i coefficienti del modello, incidendo sulla chiarezza e sulla immediatezza delle informazioni ricavate.
D10: Posso modificare la distribuzione e la funzione di collegamento dopo l'adattamento del modello?Sì, il perfezionamento del modello spesso prevede la verifica iterativa di diverse distribuzioni e funzioni di collegamento per migliorare l'adattamento e la precisione.