Foresta casuale in pratica: una guida essenziale
Imparerai come Random Forest sfrutta gli alberi decisionali per migliorare l'accuratezza predittiva in set di dati complessi.
Introduzione
Foresta casualeè un algoritmo di machine learning fondamentale che ha riscosso grande popolarità nella scienza dei dati grazie alla sua efficacia nella gestione di compiti di classificazione e regressione. Il suo successo si basa sulla capacità di costruire più alberi decisionali durante il processo di addestramento e di restituire la moda delle classi (classificazione) o la media delle previsioni (regressione) dei singoli alberi. Questa guida introduttiva è pensata per rendere Random Forest accessibile ai principianti, fornendo una spiegazione chiara e dettagliata del suo funzionamento, insieme a una guida pratica per la sua implementazione in Python. Il nostro obiettivo è fornire ai lettori le conoscenze necessarie per comprendere i fondamenti teorici di Random Forest e applicarlo efficacemente nei loro progetti di scienza dei dati, sfruttando le potenti capacità di programmazione di Python.
Punti Salienti
- Random Forest supera i singoli alberi decisionali riducendo l'overfitting.
- L'ottimizzazione degli iperparametri in Random Forest migliora in modo cruciale la precisione del modello.
- La preelaborazione dei dati è fondamentale per il successo predittivo di Random Forest.
- La guida passo passo di Python semplifica l'implementazione della foresta casuale.
- La valutazione dei modelli Random Forest implica accuratezza, precisione e metriche di richiamo.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendere la foresta casuale
Foresta casualeè un algoritmo di apprendimento automatico che si basa sul concetto di alberi decisionali per fornire un modello predittivo più accurato e robusto. Durante l'addestramento, crea numerosi alberi decisionali. In output, restituisce la classe, ovvero la moda delle classi (nella classificazione) o la previsione media (nella regressione) dei singoli alberi.
Come funziona la foresta casuale:
Alberi decisionali: Random Forest inizia con gli alberi decisionali, che sono semplici modelli decisionali ad albero. Ogni albero in un Random Forest fornisce una previsione e l'algoritmo prende il voto di maggioranza o la media nel caso di regressione come risultato finale.
Bootstrapping: questa tecnica seleziona casualmente un sottoinsieme del set di dati per ogni albero, garantendo la diversità tra gli alberi e contribuendo alla robustezza del modello.
Aggregazione (Bagging): l'algoritmo aggrega quindi le previsioni dei singoli alberi per produrre una previsione più accurata e stabile.
Vantaggi della foresta casuale:
Riduzione dell'overfitting: a differenza dei singoli alberi decisionali che spesso soffrono di overfitting sui dati di addestramento, Random Forest mitiga questo rischio grazie al suo approccio ensemble. La media delle previsioni di numerosi alberi garantisce che la previsione complessiva del modello non dipenda eccessivamente da una singola porzione dei dati di addestramento, portando a risultati più generalizzabili.
Elevata precisione: il punto di forza di Random Forest risiede nell'aggregazione delle previsioni provenienti da più alberi decisionali, ciascuno addestrato su diversi sottoinsiemi degli stessi dati. Questo metodo di ensemble aumenta significativamente la precisione delle previsioni, superando molti approcci a modello singolo su vari set di dati e tipologie di problemi.
Versatilità di applicazione: la struttura di Random Forest gli consente di eccellere in diverse attività, dalla previsione di risultati categorici in problemi di classificazione alla stima di variabili continue in analisi di regressione. La sua solida gestione di set di dati con valori mancanti e la sua capacità di elaborare dati numerici e categorici senza un'eccessiva preelaborazione lo rendono eccezionalmente flessibile.
Approfondimenti sull'importanza delle caratteristiche: una delle capacità più notevoli di Random Forest è il suo meccanismo intrinseco di selezione delle caratteristiche. Analizzando l'impatto di ciascuna caratteristica sull'accuratezza della previsione in tutti gli alberi, Random Forest è in grado di classificare l'importanza delle caratteristiche all'interno del dataset. Questa informazione è preziosa per comprendere i fattori determinanti alla base delle previsioni e può guidare la selezione delle caratteristiche nei processi di perfezionamento del modello e analisi dei dati processi.
Applicazioni della foresta casuale:
Finanza: Random Forest è ampiamente utilizzato nel settore finanziario per attività critiche come la valutazione del rischio di credito attraverso l'analisi dei punteggi di credito e la previsione dei movimenti futuri del mercato azionario, a supporto delle strategie di investimento.
E-commerce: questo algoritmo migliora l'esperienza di acquisto online alimentando sistemi di raccomandazione che suggeriscono prodotti in base al comportamento e alle preferenze dell'utente. Svolge inoltre un ruolo fondamentale nella segmentazione dei clienti in gruppi distinti per strategie di marketing e promozionali mirate.
Sanità: In ambito medico, Random Forest contribuisce alla diagnosi precoce delle malattie analizzando i dati dei pazienti alla ricerca di sintomi indicativi di specifiche patologie. Aiuta inoltre a classificare i pazienti in gruppi di rischio, facilitando la definizione di piani di trattamento personalizzati.
Sicurezza informatica: data la crescente sofisticatezza delle minacce informatiche, Random Forest contribuisce al rilevamento e alla previsione tempestivi di potenziali frodi e violazioni della sicurezza, sfruttando il rilevamento di anomalie nei modelli di dati per salvaguardare le risorse digitali.
Fondamenti teorici della foresta casuale
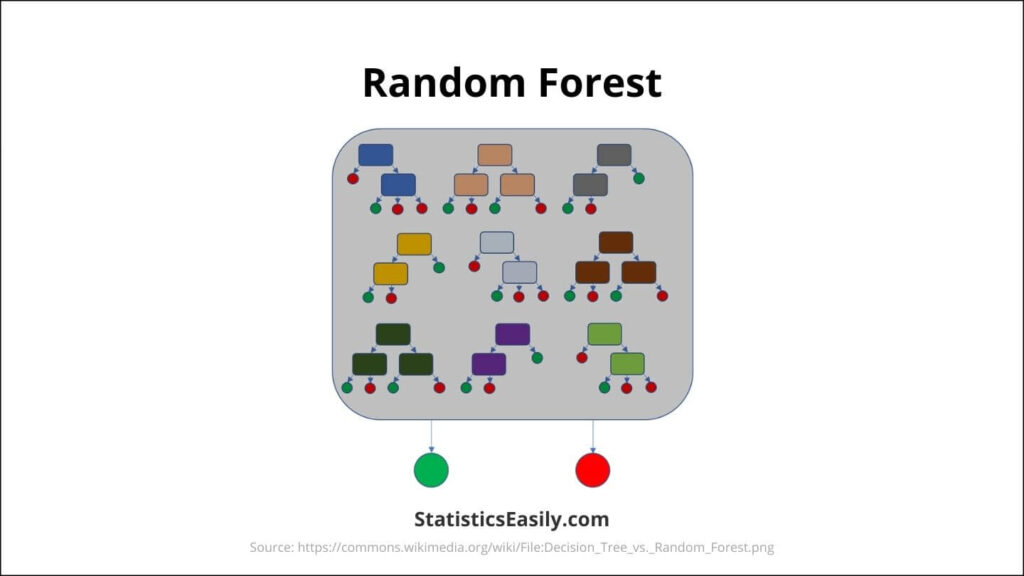
Foresta casualeopera secondo il principio dell'apprendimento d'insieme, in cui più classificatori, in questo caso alberi decisionali, vengono combinati per risolvere un problema complesso e migliorare le prestazioni del modello.
Spiegazione dettagliata dell'algoritmo:
Insieme di alberi decisionali: Random Forest crea una foresta di alberi decisionali non correlati, ciascuno addestrato su sottoinsiemi casuali dei dati di addestramento, utilizzando una tecnica di bootstrapping.
Selezione casuale delle caratteristiche: ogni albero sceglie un sottoinsieme casuale di caratteristiche ad ogni divisione. Questa casualità contribuisce a rendere gli alberi più diversificati, aumentando l'accuratezza complessiva del modello.
Aggregazione: La previsione finale del Random Forest è determinata aggregando le previsioni dei singoli alberi. Questa aggregazione riduce la varianza, controlla l'overfitting e migliora l'accuratezza predittiva del modello.
Iperparametri e il loro impatto:
Numero di alberi (n_estimatori): generalmente, l'aumento del numero di alberi migliora le prestazioni del modello, ma aumenta anche i costi computazionali.
Profondità massima (max_depth): controlla la profondità di ciascun albero. Alberi più profondi possono catturare modelli più complessi, ma potrebbero portare all'overfitting.
Numero minimo di campioni per la suddivisione (min_samples_split): determina il numero minimo di campioni necessari per suddividere un nodo interno. Valori più elevati impediscono al modello di apprendere schemi troppo specifici.
Numero massimo di caratteristiche (max_features): la dimensione dei sottoinsiemi casuali di caratteristiche da considerare durante la suddivisione di un nodo. Influisce sulla diversità degli alberi nella foresta.
Misurare l'efficacia:
Precisione: la proporzione di osservazioni correttamente previste rispetto al totale delle osservazioni. È una metrica preziosa per i problemi di classificazione bilanciata.
Matrice di confusione: una ripartizione dettagliata delle prestazioni del modello, inclusi i veri positivi, i veri negativi, i falsi positivi e i falsi negativi.
Precisione, Richiamo e Punteggio F1: La precisione è il rapporto tra le osservazioni positive correttamente previste e il totale delle osservazioni positive previste. Il richiamo (sensibilità) misura il rapporto tra le osservazioni positive correttamente previste e tutte le osservazioni nella classe effettiva. Il punteggio F1 è la media ponderata di precisione e richiamo. Queste metriche sono fondamentali nel contesto di dataset sbilanciati.
Preparazione dei dati
Un'efficace preelaborazione dei dati è un passaggio cruciale nell'apprendimento automatico che ha un impatto significativo sulle prestazioni di modelli come Random Forest. Questa sezione descrive le fasi essenziali di pulizia e preparazione dei dati, garantendo che i dati siano strutturati in modo ottimale per la modellazione di foreste casuali.
Importanza della preelaborazione dei dati:
La preelaborazione dei dati trasforma i dati grezzi in un set di dati pulito che può essere utilizzato direttamente per i modelli di machine learning. Questo processo è vitale perché influenza direttamente la capacità del modello di apprendere e fare previsioni accurate. Per Random Forest, dove sono coinvolti più alberi decisionali, la preelaborazione garantisce coerenza e qualità in tutto il set di dati, consentendo all'algoritmo di identificare i modelli in modo più efficace.
Passaggi per la pulizia e la preparazione dei dati:
1. Gestione dei valori mancanti: Random Forest è in grado di gestire i valori mancanti entro certi limiti. Tuttavia, in genere è buona norma imputare i valori mancanti utilizzando strategie come l'imputazione della media per le caratteristiche numeriche e l'imputazione della moda per le caratteristiche categoriche.
2. Codifica delle variabili categoriche: Convertire le variabili categoriche in formato numerico tramite tecniche di codifica come one-hot o label encoding, poiché Random Forest non è in grado di elaborare dati testuali grezzi.
3. Scalatura delle caratteristiche: Sebbene Random Forest non sia sensibile alla scalatura delle caratteristiche quanto algoritmi come SVM o KNN, assicurarsi che tutte le caratteristiche siano sulla stessa scala può contribuire a migliorare la convergenza del modello e l'interpretabilità dei punteggi di importanza delle caratteristiche.
4. Rimozione delle caratteristiche irrilevanti: Elimina le caratteristiche che non contribuiscono alla previsione o che potrebbero introdurre rumore. Sebbene Random Forest selezioni le caratteristiche in modo casuale durante l'addestramento, ridurre la dimensionalità in anticipo può diminuire i tempi e la complessità dell'addestramento.
Suddivisione del set di dati:
Set di addestramento e di test: dividi i tuoi dati in set di addestramento e di test per valutare le prestazioni del modello su dati non visti in precedenza. Un rapporto di suddivisione tipico è 70:30 o 80:20, dove la porzione più significativa viene utilizzata per l'addestramento.
Validazione incrociata: si consiglia di utilizzare tecniche di validazione incrociata, in particolare la validazione incrociata k-fold, per garantire che le prestazioni del modello siano coerenti su diversi sottoinsiemi di dati.
Applicazione pratica della foresta casuale con Python
Applicare Random Forest inPythonin modo efficace combina la comprensione teorica dell'algoritmo con le competenze pratiche di programmazione. Questa sezione ti guiderà nella configurazione del tuo ambiente Python, nell'implementazione di Random Forest utilizzando la libreriasklearne nella sua applicazione a un dataset reale.
Un esempio pratico: prevedere le specie di iris
Il set di dati Iris contiene 150 piante di iris, classificate in tre specie in base a quattro caratteristiche: lunghezza dei sepali, larghezza dei sepali, lunghezza dei petali e larghezza dei petali. Il modello Random Forest apprende dai dati di addestramento e prevede accuratamente le specie di piante di iris.
Seguendo i passaggi seguenti, puoi implementare Random Forests in Python per vari set di dati, non solo per il set di dati Iris. Modifica gli iperparametri del modello, come n_estimators e max_ Depth, per migliorare le prestazioni in base al set di dati e all'attività specifici.
I frammenti di codice forniti sono progettati per essere semplici da seguire, con spiegazioni per ogni passaggio per facilitare la comprensione e l'implementazione. Questa applicazione pratica dimostra la potenza delle foreste casuali nella modellazione predittiva. Fornisce una solida base per esplorare progetti di data science più complessi.
Configurazione del tuo ambiente Python
Per lavorare con Random Forest in Python, assicurati di avere Python installato sul tuo computer. Utilizza i seguenti pacchetti:
- NumPy: Per gestire array e matrici.
- Pandas: Per la manipolazione e l'analisi dei dati.
- Scikit-impara (sklearn): fornisce l'algoritmo Random Forest e funzionalità aggiuntive per la creazione di modelli predittivi.
- Matplotlib/Seaborn: Per visualizzare dati e risultati del modello.
Installa questi pacchetti usando pip:
pip install numpy pandas scikit-learn matplotlib seaborn
Implementazione della foresta casuale con sklearn
Il modulo sklearn.ensemble include RandomForestClassifier per attività di classificazione e RandomForestRegressor per attività di regressione. Ecco una guida passo passo per utilizzare RandomForestClassifier:
1. Importa le librerie necessarie:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. Carica il tuo dataset:Per questo esempio useremo il dataset Iris, un classico negli esempi di machine learning.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. Suddividi il dataset:dividi i tuoi dati in set di addestramento e di test per valutare le prestazioni del modello.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Inizializza e addestra il modello:crea un'istanza di RandomForestClassifier e adattala ai tuoi dati di addestramento.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. Effettuare previsioni e valutare il modello:utilizzare il modello addestrato per effettuare previsioni sul set di test e valutarne l'accuratezza.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
Risultati e interpretazione del modello
Dopo aver addestrato il modello e fatto previsioni, è fondamentale interpretare i risultati per comprenderne le prestazioni e come può essere migliorata.
Valutazione delle prestazioni del modello:innanzitutto, esaminare l'accuratezza del modello, quindi esplorare metriche più descrittive.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
Matrice di confusione:una matrice di confusione fornisce informazioni sulle previsioni corrette e scorrette per ciascuna classe.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
Rapporto di classificazione:Il rapporto di classificazione include metriche quali precisione, richiamo e punteggio F1 per ciascuna classe.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Importanza delle caratteristiche:Comprendere quali caratteristiche influenzano maggiormente le decisioni del modello può fornire spunti preziosi sul set di dati.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
Interpretazione del modello
Il punteggio di precisione, la matrice di confusione e il rapporto di classificazione offrono collettivamente una visione completa delle prestazioni del modello. L'elevata precisione indica l'efficacia del modello nella classificazione delle specie di iris, mentre la matrice di confusione e il rapporto di classificazione ne descrivono in dettaglio la precisione, il ricordo e i punteggi f1 tra le classi.
Il grafico dell'importanza delle caratteristiche rivela quali caratteristiche dei fiori dell'iride (come la lunghezza o la larghezza dei petali) influenzano le decisioni di classificazione del modello. Questa intuizione è preziosa per comprendere il processo decisionale del modello Random Forest e le future attività di progettazione o selezione delle funzionalità.
Interpretando questi risultati, possiamo concludere che il classificatore Random Forest è molto efficace per questo set di dati, fornendo una solida base per le attività di modellazione predittiva. Sperimentare con diversi set di dati o modificare gli iperparametri potrebbe migliorare le prestazioni del modello o l'adattabilità a vari problemi.
Interpretazione di alberi decisionali individuali all'interno della foresta casuale
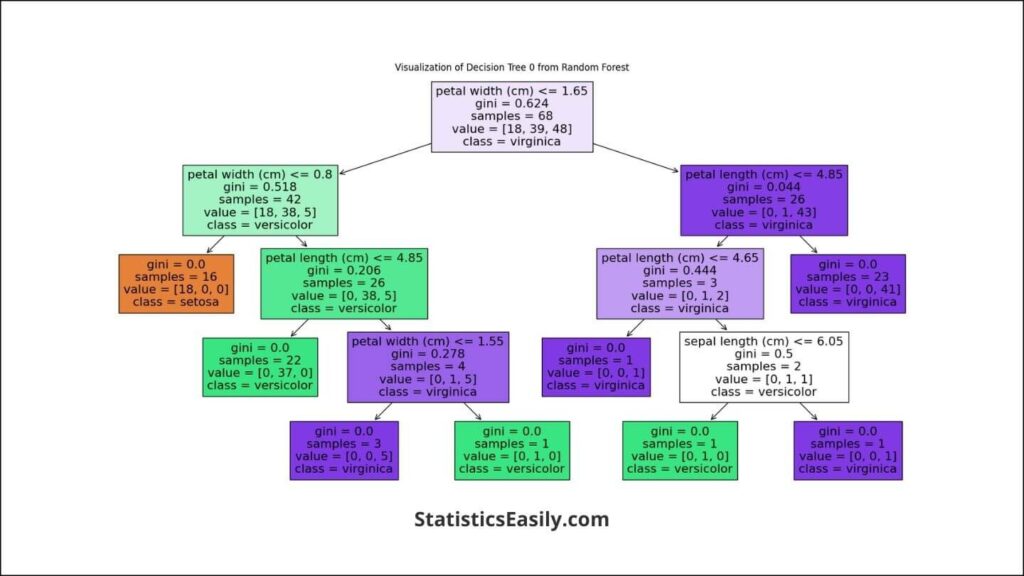
Sebbene Random Forest sia una raccolta di alberi decisionali, ciascun albero contribuisce al risultato. La visualizzazione dei singoli alberi può fornire informazioni dettagliate sul processo decisionale a un livello più granulare. Esaminiamo uno di questi alberi dal nostro modello Random Forest:
Visualizzazione di un albero decisionale dalla foresta casuale:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
Questa visualizzazione mostra come un singolo albero decisionale all'interno della foresta casuale effettua classificazioni. Inizia in alto con un nodo radice, quindi si divide in rami e nodi decisionali in base ai valori delle caratteristiche e infine termina con i nodi foglia che rappresentano le previsioni della classe.
Analizzare la struttura ad albero:
Ogni nodo dell'albero rappresenta una decisione basata sul valore di una particolare caratteristica. Ad esempio, un nodo potrebbe suddividere i dati in base alla lunghezza o alla larghezza del petalo di un fiore di iris. I rami rappresentano il risultato di quella decisione, portando a nuovi nodi decisionali o nodi foglia. I nodi foglia forniscono le previsioni finali della classe quando viene soddisfatto un insieme di criteri determinati dal percorso dalla radice.
La profondità e la complessità di questo albero indicano la strategia di classificazione del modello. In pratica, Random Forest combina le previsioni di più alberi di questo tipo per effettuare una classificazione finale e più accurata, sfruttando così i punti di forza di ciascun albero e compensandone i punti deboli.
Includere una visualizzazione dell'albero decisionale come quella generata sopra può arricchire il tuo articolo consentendo ai lettori di visualizzare il processo predittivo. Demistifica il funzionamento del modello e fornisce un esempio tangibile di come Random Forest sfrutta più percorsi decisionali per arrivare a una decisione di classificazione.
Valutare il tuo modello
Dopo aver implementato il modello Random Forest utilizzando Python, il passaggio cruciale successivo è valutarne le prestazioni. Ciò comporta l’utilizzo di metriche specifiche per comprendere quanto bene il modello predice i risultati su dati nuovi e invisibili. Questa sezione copre le metriche di valutazione critiche e offre suggerimenti per il miglioramento e l'ottimizzazione del modello.
Come valutare le prestazioni del modello di foresta casuale:
Le metriche di valutazione sono essenziali per valutare l'accuratezza e l'efficacia del modello Random Forest. Ecco le metriche più comunemente utilizzate:
Precisione: questa è la metrica più semplice, calcolata dividendo il numero di previsioni corrette per il numero totale di previsioni. Sebbene utile, l'accuratezza da sola può essere fuorviante, soprattutto in set di dati con classi sbilanciate.
Precisione e richiamo: la precisione (la proporzione di risultati veri positivi rispetto a tutte le previsioni positive) e il richiamo (la proporzione di risultati veri positivi rispetto a tutti i risultati positivi effettivi) sono fondamentali quando i costi dei falsi positivi e dei falsi negativi sono elevati, ad esempio, nella diagnosi medica o nel rilevamento delle frodi.
F1 Score: Il punteggio F1 è la media armonica di precisione e richiamo, e fornisce un'unica metrica per valutarne l'equilibrio. Il punteggio F1 raggiunge il suo valore migliore a 1 (precisione e richiamo perfetti) e il suo valore peggiore a 0.
Matrice di confusione: una tabella utilizzata per descrivere le prestazioni di un modello di classificazione su un insieme di dati di test per i quali sono noti i valori reali. Consente di visualizzare le previsioni del modello, inclusi i veri positivi, i falsi positivi, i veri negativi e i falsi negativi.
Interpretazione dei risultati:
Comprendere queste metriche consente di valutare accuratamente le prestazioni del modello. Ad esempio, un tasso di precisione elevato potrebbe sembrare eccellente a prima vista. Tuttavia, un’ulteriore ispezione tramite precisione, richiamo e punteggio F1 potrebbe rivelare aree in cui il modello presenta difficoltà, ad esempio l’incapacità di prevedere accuratamente una particolare classe.
Suggerimenti per il miglioramento e la messa a punto del modello:
Sintonia iperparametro: i modelli Random Forest hanno diversi iperparametri, come il numero di alberi (n_estimators) e la profondità degli alberi (max_depth), che possono influenzare significativamente le prestazioni. L'utilizzo di metodi di ricerca a griglia o di ricerca casuale può aiutare a trovare la combinazione ottimale di questi iperparametri per il proprio set di dati specifico.
Selezione delle caratteristiche: le foreste casuali (Random Forests) sono intrinsecamente in grado di classificare l'importanza delle caratteristiche. Analizzando ed eliminando le caratteristiche meno critiche, è possibile ridurre la complessità del modello e migliorarne le prestazioni.
Validazione incrociata: l'implementazione della convalida incrociata, come la convalida incrociata k-fold, contribuisce a garantire che le prestazioni del modello siano coerenti su diversi sottoinsiemi del dataset, aumentando così la robustezza del modello stesso.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
Questo articolo ha fornito una guida completa per comprendere e applicare Random Forest in Python, coprendone i fondamenti teorici, la preparazione dei dati, l'implementazione pratica e la valutazione del modello. Grazie alla sua capacità di gestire le attività di classificazione e regressione in modo efficace, Random Forest rimane uno strumento potente nell'arsenale dei data scientist, offrendo elevata precisione e robustezza contro l'overfitting. L'incoraggiamento a sperimentare diversi set di dati e ad affrontare vari problemi di modellazione predittiva sottolinea la versatilità e l'adattabilità di Random Forest. Seguendo i passaggi dettagliati, dalla configurazione dell'ambiente Python alla valutazione delle prestazioni del modello, i lettori sono ben attrezzati per sfruttare Random Forest nei loro progetti di data science, spingendo i confini dell'analisi predittiva.
Articoli consigliati
Scopri ulteriori approfondimenti ed esercitazioni sugli argomenti di scienza dei dati consultando gli altri nostri articoli.
- Alberi decisionali: dalla teoria alla pratica in Python per aspiranti data scientist
- Comprensione del campionamento casuale: tecniche essenziali nell'analisi dei dati
- Campionamento casuale su Excel: un'analisi approfondita
- Regressione logistica utilizzando Scikit-Learn (Storia)
- Genera un numero casuale
Domande frequenti (FAQ)
D1: Cos'è Random Forest?È un metodo di apprendimento automatico versatile, in grado di eseguire attività di regressione e classificazione, utilizzando più alberi decisionali e calcolando la media delle loro previsioni per migliorare la precisione e controllare l'overfitting.
D2: Come funziona un Random Forest?Un Random Forest crea una "foresta" di alberi decisionali casuali per rendere le sue previsioni più accurate rispetto a qualsiasi singolo albero decisionale, calcolando la media dei risultati o utilizzando il voto a maggioranza.
D3: Perché Random Forest è preferito rispetto ad altri algoritmi?È preferito per la sua versatilità, la capacità di gestire grandi insiemi di dati con dimensionalità elevata e la capacità di gestire i valori mancanti, il che lo rende robusto contro l'overfitting.
D4: Quali sono le principali applicazioni di Random Forest?È ampiamente utilizzato in vari settori, come quello bancario, medico, del mercato azionario e dell'e-commerce, per il rilevamento delle frodi, la previsione delle malattie, la previsione dei prezzi delle azioni e la segmentazione della clientela.
D5: Come si preparano i dati per Random Forest?La preparazione dei dati prevede la pulizia, la gestione dei valori mancanti, la codifica delle variabili categoriche e la suddivisione del dataset in set di addestramento e di test.
D6: Cosa sono gli iperparametri in Random Forest e come influenzano il modello?Gli iperparametri influenzano la complessità e le prestazioni del modello, come il numero di alberi, la profondità degli alberi e la suddivisione minima dei campioni. La loro regolazione può migliorare significativamente la precisione.
D7: Come si può valutare l'efficacia di un modello Random Forest?Le metriche di valutazione standard includono accuratezza, precisione, richiamo, punteggio F1 e matrice di confusione, che aiutano a valutare le prestazioni predittive e l'accuratezza del modello.
D8: Quali sono alcune delle difficoltà nell'utilizzo delle foreste casuali?Sebbene potenti, le foreste casuali possono essere computazionalmente intensive e difficili da interpretare rispetto a modelli più semplici, e le loro prestazioni possono essere sensibili ai dati rumorosi.
D9: Come si ottimizza un modello Random Forest per ottenere prestazioni migliori?L'ottimizzazione del modello prevede la regolazione di iperparametri come il numero di alberi, la profondità massima e il numero minimo di campioni suddivisi tramite tecniche di ricerca a griglia o casuale per trovare le impostazioni più ottimali.
D10: Random Forest può gestire sia dati categorici che numerici?Sì, Random Forest può gestire un mix di dati categorici e numerici. Utilizza tecniche come la codifica one-hot per le variabili categoriche per rendere i dati adatti alla modellazione.