Alberi decisionali: dalla teoria alla pratica in Python per aspiranti data scientist
Imparerai i principi fondamentali di Decision Trees e la loro applicazione pratica in Python per approfondimenti basati sui dati.
Introduzione
Alberi decisionalisono un elemento fondamentale analisi dei dati, nella scienza dei dati e nell'apprendimento automatico, offrendo un framework che semplifica processi decisionali complessi grazie alla sua struttura intuitiva. Questi modelli scompongono i dati in segmenti comprensibili, consentendo sia a esperti navigati che a principianti di individuare schemi e informazioni con chiarezza. L'eleganza degliAlberi decisionalirisiede nella loro capacità di trasformare set di dati complessi in informazioni visivamente comprensibili e logicamente organizzate, facilitando decisioni e previsioni consapevoli. Questa esplorazione introduttiva getterà le basi per sfruttareAlberi decisionali in Python, guidando gli aspiranti data scientist dalla comprensione teorica all'applicazione pratica.
Punti Salienti
- Gli alberi decisionali classificano i dati con semplicità e precisione senza precedenti.
- Scikit-learn di Python rende semplice l'implementazione degli alberi decisionali.
- Gli alberi decisionali illuminano dati complessi, offrendo percorsi chiari al processo decisionale.
- Le tecniche di ottimizzazione migliorano la precisione degli alberi decisionali senza adattamenti eccessivi.
- La visualizzazione degli alberi decisionali in Python demistifica i processi di analisi dei dati.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprensione degli alberi decisionali
Alberi decisionalisono un metodo di analisi dei dati che presenta una struttura gerarchica delle decisioni e delle loro possibili conseguenze, inclusi gli esiti di eventi casuali, i costi delle risorse e l'utilità. Questo metodo è particolarmente efficace nella scienza dei dati per la sua chiarezza nel processo decisionale e per la sua interpretabilità.
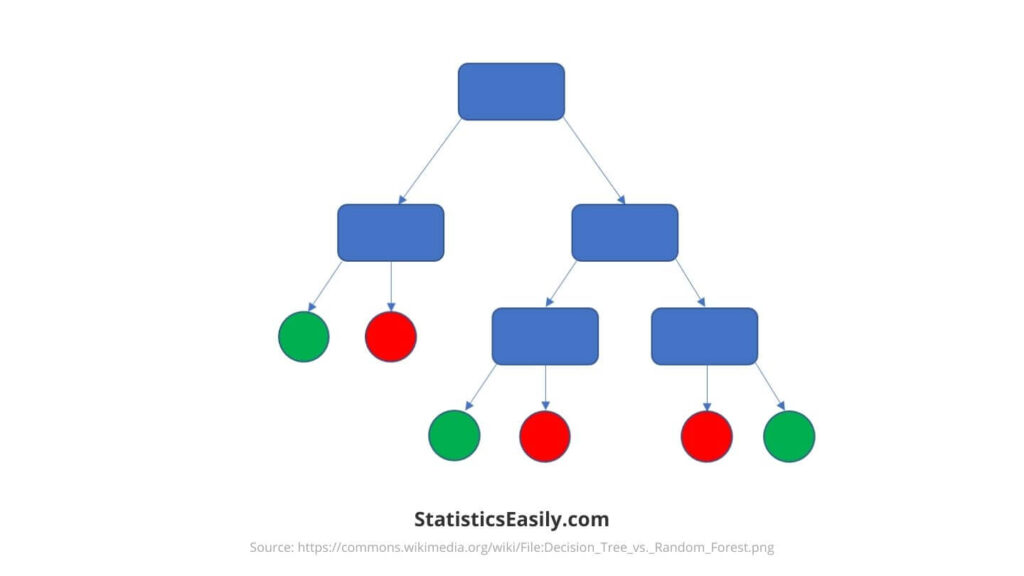
In sostanza,Alberi decisionalisuddividono i dati in rami in base a criteri di decisione derivati dalle caratteristiche del dataset. Queste suddivisioni avvengono in corrispondenza dei nodi, con il primo nodo che rappresenta la radice dell'albero. Ogni nodo rappresenta un punto decisionale e i rami rappresentano l'esito di tale decisione, portando a ulteriori suddivisioni fino a quando i nodi foglia rappresentano i risultati o le previsioni.
La creazione di unalbero decisionaleimplica la determinazione della caratteristica migliore su cui basare la suddivisione a ogni passaggio. Questa decisione si basa su metriche come l'indice di Gini o l'entropia nei compiti di classificazione e la riduzione della varianza nella regressione. Questi criteri aiutano a scegliere le suddivisioni che purificano in modo più efficace i nodi figli.
La profondità di unalbero decisionalemisura il percorso più lungo dalla radice a una foglia. Un albero più profondo potrebbe modellare i dati di addestramento in modo più accurato, ma rischia anche di incorrere nell'overfitting, ovvero una condizione in cui il modello si comporta bene sui dati di addestramento ma male sui dati non visti. Al contrario, un albero poco profondo potrebbe essere troppo semplice per catturare la struttura sottostante dei dati, portando all'underfitting.
Alberi decisionalisono apprezzati per la loro capacità di modellare processi decisionali complessi, combinando semplicità e robustezza. Possono gestire sia dati numerici che categorici, risultando versatili per un'ampia gamma di applicazioni. Inoltre, la loro struttura consente una facile visualizzazione e interpretazione, rendendoli uno strumento accessibile per gli scienziati dei dati che desiderano comunicare i propri risultati.
Il fondamento teorico degliAlberi decisionalipone l'accento sull'esecuzione tecnica e sulla chiara presentazione delle decisioni basate sui dati. Ciò si allinea con la ricerca della verità e della comprensione nella scienza dei dati, illustrando come i dati possano essere analizzati per rivelare informazioni utili a prendere decisioni concrete e consapevoli. Attraverso questo metodo, gli scienziati dei dati possono gestire la complessità dei loro dataset, scoprire modelli e prevedere i risultati con un equilibrio tra precisione e semplicità.
Il significato degli alberi decisionali nell'analisi dei dati
L'applicazione diAlberi decisionalisi estende ben oltre un singolo ambito, dimostrando una versatilità senza pari in diversi settori, tra cui l'analisi aziendale, la sanità, la finanza e molti altri. Nell'ambito del processo decisionale aziendale, ad esempio,Alberi decisionaliper la previsione delle diagnosi, la valutazione del rischio del paziente e l'analisi dell'efficacia dei trattamenti, offrendo una guida per la medicina personalizzata e un miglioramento dell'assistenza al paziente.
Uno dei principali vantaggi degliAlberi decisionaliè la loro interpretabilità. A differenza di molti modelli complessi che agiscono come "scatole nere",Alberi decisionalivisualizzano il processo decisionale, consentendo agli utenti di comprendere come si giunge alle conclusioni. Questa trasparenza è preziosa in settori in cui comprendere la logica alla base di una previsione è fondamentale quanto la previsione stessa, come ad esempio la sanità e la finanza.
Inoltre, la facilità d'uso degliAlberi decisionaliè degna di nota. Non richiedono una complessa preparazione dei dati; i dati categorici e numerici possono essere gestiti direttamente e le relazioni non lineari tra i parametri non ne influenzano le prestazioni. Questa caratteristica di usabilità garantisce cheAlberi decisionalirimangano accessibili a un vasto pubblico, compresi coloro che hanno competenze statistiche o di programmazione limitate.
Il pregio degliAlberi decisionaliin ambito analitico risiede nella loro capacità di coniugare semplicità e potenti capacità predittive. Possono essere applicati a problemi di regressione e classificazione, risultando così uno strumento versatile nell'arsenale del data scientist. Inoltre, la loro struttura consente una facile applicazione di tecniche come la potatura, che aiuta a evitare l'overfitting e garantisce la robustezza e l'affidabilità del modello.
Preparazione dei dati per un modello di alberi decisionali
La preparazione dei dati è una fase cruciale nella modellazione, soprattutto quando si lavora conAlberi decisionali. Questa sezione approfondisce i passaggi essenziali per la preparazione del dataset: pulizia e suddivisione in set di training e di test. Ogni passaggio garantisce l'integrità del modello e riflette la rigorosa ricerca della verità nella scienza dei dati.
La pulizia dei datiimplica l'identificazione e la correzione di errori o incongruenze nel set di dati. Ciò può significare gestire i valori mancanti, rimuovere i duplicati o correggere gli errori di immissione dei dati. PerAlberi decisionali, garantire che i dati siano privi di inesattezze è fondamentale, poiché tali modelli interpretano direttamente la struttura e il contenuto dei dati. Dati puliti costituiscono la base su cui vengono costruiti modelli affidabili e interpretabili.
La suddivisione dei datiin set di addestramento e di test è un passaggio fondamentale per valutare l'efficacia del modelloalbero decisionale. I dati vengono generalmente suddivisi in modo casuale, con una ripartizione standard del 70% per l'addestramento e del 30% per il test. Il set di addestramento serve a costruire il modello, mentre il set di test ne valuta le prestazioni su dati non visti in precedenza. Questo passaggio è cruciale per valutare la generalizzabilità del modello, garantendo che possa effettuare previsioni accurate su dati nuovi e non ancora analizzati. È l'essenza della creazione di modelli che riflettano la realtà e che siano affidabili nel prendere decisioni.
Costruisci i tuoi primi alberi decisionali in Python
La creazione di unalbero decisionalein Python demistifica il processo di analisi dei dati e di apprendimento automatico, rendendolo accessibile anche ai principianti. Questa sezione ti guiderà nella creazione del tuo primoalbero decisionaleutilizzando Python, ponendo l'accento sull'esperienza pratica e sulla chiarezza.
Configurazione del tuo ambiente Python
1. Assicurati di avere Python installato sul tuo computer. Puoi scaricarlo dapython.org.
2. Installa le librerie necessarie utilizzando pip, il programma di installazione dei pacchetti Python. Apri il terminale o il prompt dei comandi ed esegui:
pip install numpy pandas scikit-learn matplotlib
Questi comandi installano NumPy e panda per la manipolazione dei dati, scikit-learn per l'apprendimento automatico e matplotlib per la visualizzazione.
Caricamento e preparazione del set di dati
1. Importa le librerie e carica il tuo set di dati. Per questo tutorial, utilizziamo il set di dati Iris, un set di dati semplice ma approfondito disponibile direttamente in scikit-learn.
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris()
data = pd.DataFrame(data=iris.data, columns=iris.feature_names)
data['target'] = iris.target
2. Pulisci il tuo set di dati controllando e gestendo valori mancanti o valori anomali. Il set di dati Iris è già pulito, quindi non sono necessarie ulteriori azioni qui.
3. Suddividi il tuo set di dati in set di training e test per valutare accuratamente le prestazioni del tuo modello.
from sklearn.model_selection import train_test_split

X = data.drop('target', axis=1)
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Implementazione di un modello di albero decisionale con Scikit-learn
1. Importa DecisionTreeClassifier da scikit-learn e crea un'istanza del classificatore.
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(random_state=42)
2. Adatta il modello ai tuoi dati di addestramento.
dtree.fit(X_train, y_train)
Visualizzare l'albero decisionale
1. Visualizza l'albero decisionaleaddestrato per comprenderne il funzionamento nel processo decisionale.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20,10))
plot_tree(dtree, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
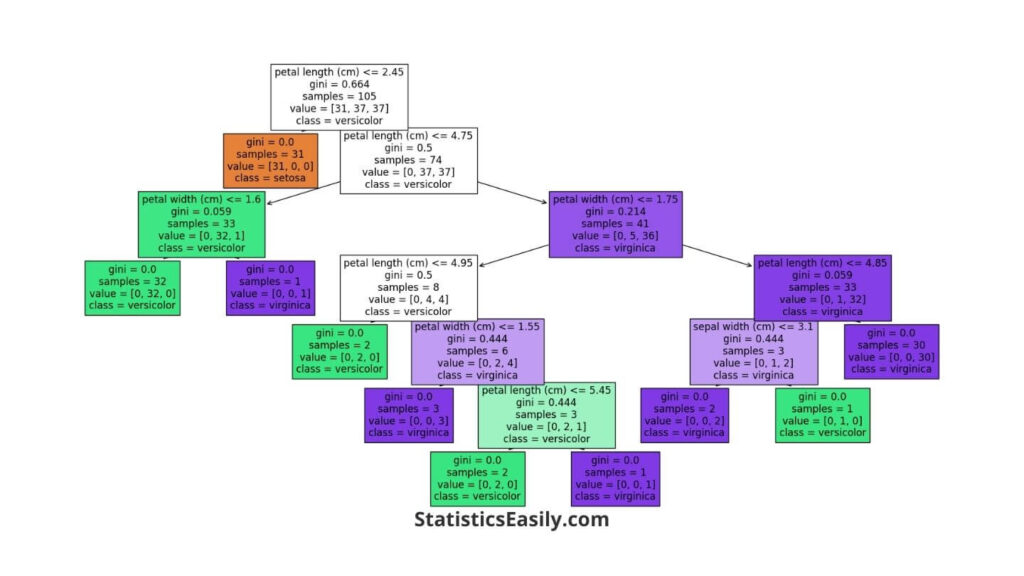
Questa immagine rappresenta un modello di albero decisionale addestrato per classificare i fiori di iris in una delle tre specie. Si basa sul set di dati Iris, che include misurazioni come la lunghezza e la larghezza dei petali. Ecco una ripartizione di ciò che vediamo in questo albero decisionale:
- Nodi (rettangoli):Ogni rettangolo è un nodo che prende una decisione. L'albero inizia con il nodo radice in alto e termina con il nodo foglia. I nodi testano i dati in base a criteri specifici, ad esempio se la lunghezza del petalo è inferiore a un valore particolare.
- Diramazioni (Linee che collegano i nodi):Queste linee guidano il percorso da una decisione a quella successiva in base ai criteri stabiliti dai nodi.
- Nodi foglia (rettangoli finali):I nodi finali (foglie) ci danno la classe prevista (tipo di fiore dell'iride). Non si dividono ulteriormente perché rappresentano la previsione più informata che il modello può fare con i dati forniti.
- Gini (metrica in nodi):Il punteggio Gini misura la purezza: 0 significa interamente puro (tutti i campioni in un nodo appartengono alla stessa classe) e punteggi più alti indicano un mix di classi all'interno di un nodo.
- Esempi (nei nodi):Questo ci dice quanti esempi dei dati vengono considerati in questo punto dell'albero.
- Valore (nei nodi):Questa matrice mostra la distribuzione delle classi nei campioni in quel nodo. Ad esempio, [0, 34, 2] significa 0 setosas, 34 versicolors e 2 virginicas.
- Classe (nei nodi):Questa è la previsione del modello in quel nodo. L'albero decisionale etichetterà qualsiasi punto dati in quel nodo con questa classe.
Osservando questo albero decisionale, possiamo tracciare il percorso decisionale dall'alto verso il basso. Ad esempio, supponiamo di avere un fiore di iris con una lunghezza del petalo inferiore a 2.45 cm. In tal caso, l'albero decisionale lo classificherà come setosa (come visto nel nodo foglia più a sinistra). L'albero fornisce un modo trasparente per vedere esattamente come il modello giunge ad una conclusione in base alle caratteristiche di input.
Esempio pratico
L'utilizzo del dataset Iris consente di esplorare le sfumature degliAlberi decisionalisenza essere sopraffatti da dati complessi. Grazie alla sua semplicità e alla sua applicabilità nel mondo reale, questo dataset garantisce chiarezza e coinvolgimento, aiutandoti a comprendere le basi degliAlberi decisionali in Python.
Hai creato e visualizzato il tuo primoalbero decisionaleseguendo questi passaggi. Questo processo, dalla configurazione dell'ambiente all'analisi di un semplice set di dati, dimostra la potenza e l'accessibilità del machine learning in Python.Alberi decisionalioffrono un metodo robusto e interpretabile per i data scientist di qualsiasi livello, sia per l'analisi predittiva, l'esplorazione dei dati o l'ottenimento di informazioni da set di dati complessi.
Valutazione e ottimizzazione del modello degli alberi decisionali
Dopo aver creato il tuo modello di albero decisionale in Python, i passaggi critici successivi sono la valutazione e l'ottimizzazione. Questi processi garantiscono che il tuo modello funzioni in modo efficace e faccia previsioni accurate.
Valutare il modello dell'albero decisionale
Le prestazioni del modello Decision Tree possono essere valutate utilizzando parametri quali accuratezza, precisione e richiamo. L'accuratezza misura la proporzione di previsioni corrette, la precisione riflette la capacità del modello di identificare solo i casi rilevanti e il richiamo indica la capacità del modello di trovare tutti i casi pertinenti all'interno del set di dati.
from sklearn.metrics import accuracy_score, precision_score, recall_score

predictions = dtree.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions)}")
print(f"Precision: {precision_score(y_test, predictions, average='macro')}")
print(f"Recall: {recall_score(y_test, predictions, average='macro')}")
Tecniche per l'ottimizzazione degli alberi decisionali
L'ottimizzazione dell'albero decisionale comporta la regolazione dei parametri per migliorare le prestazioni e prevenire l'adattamento eccessivo. Le tecniche chiave includono:
Potatura: Riduzione delle dimensioni dell'albero per rimuovere le sezioni con scarsa capacità di classificare le istanze. La potatura può essere effettuata impostando parametri come max_depth, che limita la profondità dell'albero, e min_samples_split, che specifica il numero minimo di campioni necessari per suddividere un nodo interno.
dtree_optimized = DecisionTreeClassifier(max_depth=3, min_samples_split=5, random_state=42)
dtree_optimized.fit(X_train, y_train)
Profondità massima: limitare la profondità dell'albero aiuta a evitare che il modello diventi eccessivamente complesso e si adatti eccessivamente ai dati di addestramento.
Suddivisione minima dei campioni: impostare un numero minimo di campioni per la suddivisione di un nodo contribuisce a rendere il modello più generale e meno soggetto all'inserimento di rumore nel set di addestramento.
Considerazioni etiche nell'ottimizzazione del modello
L'ottimizzazione di un modello va oltre i semplici aggiustamenti tecnici; implica considerazioni etiche, in particolare garantire che le previsioni del modello siano giuste e non perpetuino pregiudizi. L'adattamento eccessivo influisce sulla precisione del modello sui dati invisibili. Può portare a decisioni che potrebbero non riflettere la vera natura dei dati o della realtà. È fondamentale bilanciare la complessità del modello con la sua interpretabilità ed equità, garantendo che le decisioni prese dal modello siano giustificabili ed etiche.
Garantire che i modelli riflettano accuratamente la realtà sottolinea il nostro impegno verso la verità. Implica test rigorosi su diversi set di dati per rilevare e mitigare i pregiudizi. Ai data scientist è affidata la responsabilità etica di garantire che i loro modelli servano al bene, evitando danni che potrebbero derivare da previsioni imprecise.
Titolo dell'annuncio
Descrizione dell'annuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusione
Il percorso attraverso le complessità degliAlberi decisionaliha rivelato la profonda capacità di questi modelli di rendere la scienza dei dati accessibile ed efficace. Grazie a una combinazione di semplicità e profondità,Alberi decisionalioffrono una prospettiva per analizzare set di dati complessi, rendendo più agevole prendere decisioni informate. Questa esplorazione, dai concetti teorici all'applicazione pratica in Python, evidenzia la versatilità e la potenza degliAlberi decisionali, testimoniando la bellezza stessa della scienza dei dati.
Articoli consigliati
Scopri altre tecniche e approfondimenti all'avanguardia nella scienza dei dati sul nostro blog. Immergiti più a fondo negli alberi decisionali e oltre per una comprensione completa e un'applicazione pratica nei tuoi progetti. Esplora ora!
- Statistica descrittiva e statistica inferenziale: semplificare l'analisi dei dati
- Modelli lineari generalizzati in Python: una guida completa
- Regressione lineare con Scikit-Learn: una guida completa
- P-hacking: una minaccia nascosta per un'analisi affidabile dei dati
- Regressione logistica utilizzando Scikit-Learn (Storia)
- I 5 migliori strumenti gratuiti per l'analisi dei dati nel 2024
Domande frequenti (FAQ)
D1: Cosa sono gli alberi decisionali?Gli alberi decisionali sono modelli predittivi non lineari utilizzati per attività di classificazione e regressione nella scienza dei dati.
D2: Perché gli alberi decisionali sono importanti nell'analisi dei dati?Offrono spunti intuitivi e chiari su set di dati complessi, rendendoli essenziali per processi decisionali informati.
D3: Come funzionano gli alberi decisionali in Python?Le librerie di Python, come scikit-learn, consentono una facile implementazione e visualizzazione degli alberi decisionali.
D4: Gli alberi decisionali possono essere utilizzati sia per la classificazione che per la regressione?Sì, gli alberi decisionali possono gestire entrambi i tipi di attività in modo efficiente, il che li rende strumenti versatili nella scienza dei dati.
D5: Cosa rende gli alberi decisionali così preziosi?La loro semplicità e interpretabilità, senza sacrificare la precisione, li rendono indispensabili per analisti e scienziati.
D6: Come si valuta la performance di un albero decisionale?Utilizzando metriche come accuratezza, precisione e richiamo, oltre all'ispezione visiva dell'albero stesso.
D7: Quali sono le principali sfide con gli alberi decisionali?L'overfitting può essere problematico e richiede tecniche come la potatura per gestire la complessità dell'albero.
D8: Come gestiscono gli alberi decisionali i dati categorici e numerici?Intrinsicamente, possono gestire entrambi i tipi, suddividendo i nodi in base al tipo di dato per ottimizzare le decisioni.
D9: Cos'è la potatura negli alberi decisionali?La potatura riduce le dimensioni degli alberi decisionali rimuovendo le sezioni dell'albero che offrono una scarsa capacità di classificazione delle istanze.
D10: Come si possono visualizzare gli alberi decisionali in Python?Utilizzando librerie come matplotlib e Graphviz, gli alberi decisionali possono essere rappresentati visivamente per un'interpretazione più immediata.